OpenAI

La difficoltà di riconoscere il vero e il rifugio nella compatibilità /  by Filippo Venturi

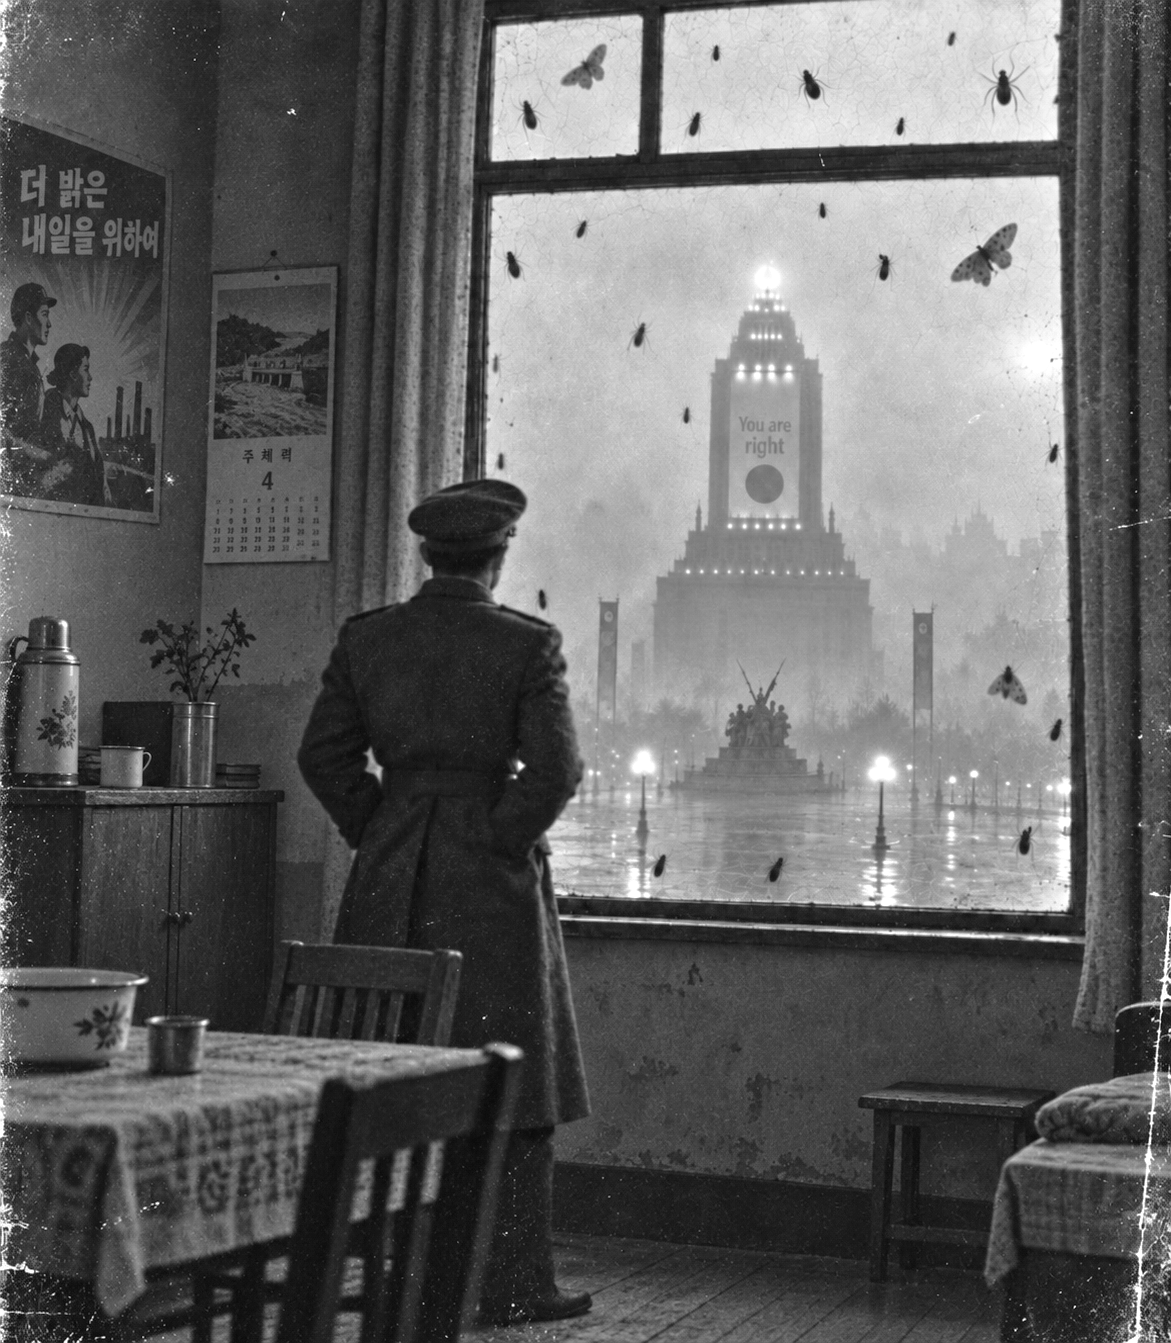
[Immagine generata con IA, dal progetto “Broken Mirror” @ Filippo Venturi]

La fine della contraddizione?

La difficoltà di riconoscere il vero e il rifugio nella compatibilità

In un lungo articolo del New York Times, intitolato “The World’s Leading Deepfake Expert No Longer Trusts His Own Eyes”, Hany Farid, uno dei maggiori esperti mondiali di digital forensics e deepfake, racconta di essere arrivato a un punto in cui non si fida più dei propri occhi. Dopo oltre vent’anni trascorsi a distinguere immagini autentiche da manipolazioni, ora si trova ad analizzare quotidianamente fotografie, video e registrazioni audio generate dall’intelligenza artificiale sempre più difficili da riconoscere, tanto che anche i contenuti reali richiedono verifiche complesse prima di poter essere considerati attendibili. Sempre più spesso non è possibile ottenere una risposta definitiva su ciò che guardiamo.

Questa incertezza è entrata perfino nella sua vita privata. Dopo che qualcuno ha clonato la sua voce con l’IA e falsificato il suo numero di telefono per cercare di ottenere informazioni riservate da un suo collega, Farid e sua moglie hanno stabilito una parola d’ordine da utilizzare nelle telefonate più delicate per verificare reciprocamente la propria identità. Questo scenario lo ha infine spinto ad allontanarsi dalla Silicon Valley e a trasferirsi in una fattoria nei boschi del Vermont, alla ricerca di una dimensione più concreta e meno mediata dagli schermi.

Una sensazione analoga mi accompagna sempre più spesso nelle mie verifiche, soprattutto quando si parla di fotografie (o presunte tali) legate al mondo dell’informazione. È noto che la disinformazione abbia spesso il vantaggio della velocità, capillarità e semplicità, mentre verificare richiede tempo, fonti e competenze e l’eventuale smentita raggiungerà poche persone. Resta comunque una missione necessaria, per quanto insufficiente senza una regolamentazione dall'alto.

Da bambini il mondo ci entra dagli occhi senza chiedere permesso. Quello che vediamo o pensiamo di vedere, esiste. Il mostro sotto il letto, il mago in televisione, l’eroe che vola sullo schermo. Crescendo impariamo lentamente che le immagini possono ingannare, che esistono trucchi, montaggi, finzioni. È una forma di educazione dello sguardo. Perdiamo l’innocenza, ma in cambio acquistiamo strumenti.

In un futuro prossimo, probabilmente, torneremo in una condizione infantile, ma rovesciata: non crederemo a ciò che vediamo. Dopo aver imparato per tutta la vita a distinguere la realtà dalla finzione, ci troviamo davanti a uno scenario di dubbio perpetuo.

Per quasi due secoli la fotografia ha costruito gran parte della propria forza sulla relazione fisica con ciò che si trovava davanti all’obiettivo. Poteva mentire, naturalmente. Poteva essere manipolata, costruita, selezionata, decontestualizzata. Ma qualcosa, davanti alla macchina fotografica, era stato necessario. La fotografia poteva deformare il reale, ma non prescindere completamente da esso.

E per quanto ci sia chi abbia cercato di demolire completamente la credibilità della fotografia, difficilmente rinunceremmo alle nostre foto di famiglia solo perché mostrano un frammento, un istante parziale o una versione incompleta del nostro rapporto con un genitore, un parente o un amico. Sappiamo che non raccontano tutto, ma continuiamo a riconoscere in esse una traccia di qualcosa che è realmente accaduto. La loro parzialità non annulla il loro valore di testimonianza.

La consapevolezza che il nostro impegno non sia più sufficiente (se mai lo è stato) per scegliere a cosa credere, anche dopo verifiche e approfondimenti, introduce una forma di impotenza nuova. La nostra necessità di adattamento, ci spingerà a trovare un compromesso e questo compromesso, probabilmente, consisterà nel non credere più a nulla. O forse, più plausibilmente, a credere a ciò di cui siamo già convinti. A quel punto il criterio non sarà più la verità, ma la compatibilità.

Accetteremo più facilmente ciò che conferma il nostro sistema di convinzioni e respingeremo ciò che lo mette in crisi. In questo senso, l’intelligenza artificiale non introdurrebbe un meccanismo nuovo, ma amplificherebbe qualcosa che i social network hanno già reso evidente ovvero la tendenza a vivere all’interno di bolle informative, a selezionare le conferme e a evitare ciò che produce dissonanza.

Il rischio più subdolo è quello di perdere progressivamente la disponibilità a lasciarci contraddire dalle immagini.


The End of Contradiction?

The difficulty of recognising truth, and the refuge of compatibility

In a long New York Times article entitled “The World’s Leading Deepfake Expert No Longer Trusts His Own Eyes”, Hany Farid, one of the world’s leading experts in digital forensics and deepfakes, describes having reached the point where he no longer trusts his own eyes. After more than twenty years spent distinguishing authentic images from manipulated ones, he now finds himself analysing photographs, videos and audio recordings generated by artificial intelligence on a daily basis, increasingly difficult to identify as such. Even genuine content now requires complex verification before it can be regarded as reliable. More and more often, it is impossible to arrive at a definitive answer about what we are looking at.

This uncertainty has even entered his private life. After someone cloned his voice using AI and spoofed his telephone number in an attempt to obtain confidential information from one of his colleagues, Farid and his wife agreed on a safe word to use during sensitive phone calls in order to verify each other’s identity. This situation ultimately led him to move away from Silicon Valley and settle on a farm in the woods of Vermont, in search of a more tangible existence, less mediated by screens.

I increasingly experience a similar feeling in my own verification work, particularly when dealing with photographs — or supposed photographs — connected to the news. Disinformation often has the advantage of speed, reach and simplicity, whereas verification requires time, sources and expertise, and any subsequent correction will reach only a fraction of those who encountered the original claim. It nevertheless remains a necessary task, however insufficient it may be without regulation at a systemic level.

As children, the world enters through our eyes without asking permission. What we see, or believe we see, exists. The monster under the bed, the magician on television, the hero flying across the screen. As we grow older, we gradually learn that images can deceive us, that tricks, editing and fiction exist. It is a form of visual education. We lose our innocence, but in exchange we acquire tools.

In the near future, perhaps, we will return to a kind of childhood condition, but in reverse: we will no longer believe what we see. After spending our entire lives learning to distinguish reality from fiction, we now find ourselves facing a state of perpetual doubt.

For almost two centuries, photography has derived much of its power from its physical relationship with whatever stood in front of the lens. It could lie, of course. It could be manipulated, constructed, selected or taken out of context. But something had to have been there, in front of the camera. Photography could distort reality, but it could not dispense with it altogether.

And however much some have sought to dismantle photography’s credibility entirely, few of us would be willing to give up our family photographs simply because they show only a fragment, a partial moment or an incomplete version of our relationship with a parent, relative or friend. We know they do not tell the whole story, but we continue to recognise in them a trace of something that really happened. Their partial nature does not erase their value as testimony.

The realisation that our own efforts are no longer sufficient — if they ever were — to determine what to believe, even after verification and careful investigation, introduces a new form of powerlessness. Our need to adapt will push us towards some kind of compromise, and that compromise will probably consist in no longer believing anything at all. Or perhaps, more plausibly, in believing what we are already convinced of. At that point, the criterion will no longer be truth, but compatibility.

We will more readily accept what confirms our existing system of beliefs and reject what challenges it. In this sense, artificial intelligence would not introduce an entirely new mechanism, but rather amplify something that social networks have already made apparent: the tendency to live within information bubbles, to select confirmation and to avoid whatever produces dissonance.

The more insidious risk is that we gradually lose our willingness to allow images to contradict us.
The Tamed Machine. A personal reflection prompted by a provocation from Fred Ritchin /  by Filippo Venturi

The Tamed Machine
A personal reflection prompted by a provocation from Fred Ritchin

An article published on 16 September 2026 by Fred Ritchin — a well-known American critic, former picture editor of The New York Times Magazine and Dean Emeritus of the International Center of Photography, and one of the most authoritative voices on the relationship between photography and new technologies — entitled “A possible photographic renaissance?” made me think again about some of the ideas I had expressed during presentations of some of my projects. In particular, those in which I combined photography with images generated by artificial intelligence, such as Broken Mirror (2023) and He Looks Like You (2023–2024).

At the time, I used to say that the phase in AI’s development that interested me most was the one in which the tool was still imperfect, unpredictable and, in some way, resistant to my intentions. A kind of mischievous assistant with whom I had to compromise, but whose bizarre suggestions I could also, at times, accept.

It was precisely this characteristic that formed one of the conceptual premises of Broken Mirror, in which I expressed my concerns about the invasive and controlling nature of dictatorship, but also of technology, and of He Looks Like You, in which I could mistake unpredictability for authenticity, allowing myself, for a moment, to believe in the illusion suggested by those images: that my father and my son had actually met.

I would conclude by saying that, once generative AI became more reliable and predictable, I would probably lose the curiosity that had driven me to experiment with it.

In his article, Ritchin argues that AI-generated imagery has, over time, become more predictable and banal, increasingly approximating the look of generic stock photography. In the early years, by contrast, what struck him was precisely the ability of these systems to produce unexpected, strange and sometimes even “revelatory” results. According to him, increasingly stringent guardrails and models trained on an enormous surfeit of conventional images are contributing to results that are less unpredictable and less original. Hence his final question: if AI is tending towards increasingly standardised imagery, might photographers respond by seeking greater complexity, ambiguity and originality?

This observation, which I share, makes me think, in some ways, that the moment I was talking about a few years ago may already have arrived.

Not because artificial intelligence has truly become reliable today — it continues to make mistakes, invent information and produce absurd results — but because, at least when it comes to image generation, its unpredictability seems less and less interesting to me. It is a more controlled, tamed unpredictability, enclosed within an aesthetic that tends to repeat itself.

What fascinated me was not the possibility of obtaining exactly the image I had in mind. On the contrary, it was the moment when the machine seemed to misunderstand my request and return something I had not anticipated. Something could happen in that gap between intention and result. Sometimes nothing interesting, of course (while working on He Looks Like You, I spent dozens of fruitless and frustrating nights searching for the generated image I was looking for). At other times, however, an image would emerge that was capable of suggesting a direction I myself had not imagined.

Perhaps that was where, at least for me, the most compelling part of the creative process lay: not in controlling the tool, but in negotiating with something that I could not completely control. This does not mean that I have stopped being interested in artificial intelligence. What is probably changing is simply the reason why it interests me.

Less and less as a machine with which to produce images, and more and more as a phenomenon to observe: to understand how it is changing our relationship with photography, with information, with memory and, above all, with the trust we place in images.

And it is perhaps here that I find Ritchin’s final provocation particularly interesting. If AI is destined to produce formally perfect but conventional images with ever greater ease, perhaps photography should not try to compete on the same terrain.

Photography does not need to become deliberately strange or imperfect in order to distinguish itself from AI; its strength may lie precisely in its encounter with a reality that often does not obey the photographer, one that may prevent them from achieving the result they had envisaged but may also offer unimaginable opportunities. However much the photographer may study, prepare and imagine the result, there is always the possibility that something will contradict their expectations, surprise them and introduce an element of unpredictability into the image. Perhaps it is also there that photography can rediscover part of its value: in its ability to leave room for what reality offers that is unexpected and could not have been foreseen.


La macchina addomesticata
Una riflessione personale a partire da una provocazione di Fred Ritchin

Un articolo pubblicato il 16 settembre 2026 da Fred Ritchin — noto critico statunitense, già picture editor del New York Times Magazine e preside emerito dell’International Center of Photography, tra le voci più autorevoli sul rapporto tra fotografia e nuove tecnologie — intitolato “A possible photographic renaissance?“ mi ha fatto ripensare ad alcuni ragionamenti che avevo espresso durante le presentazioni di alcuni miei lavori. In particolare quelli in cui combinavo fotografia e immagini generate con l’intelligenza artificiale, come Broken Mirror (2023) e He Looks Like You (2023-2024).

All’epoca dicevo che la fase dell’IA che mi interessava maggiormente era quella in cui lo strumento era ancora imperfetto, imprevedibile e, in qualche modo, resistente alle mie intenzioni. Una sorta di assistente dispettoso con cui scendere a compromessi, ma dal quale accettare anche, in alcuni casi, suggerimenti bizzarri.

Era proprio questa caratteristica a costituire uno dei presupposti concettuali di Broken Mirror, dove esprimevo i miei timori sulla natura invasiva e controllante della dittatura, ma anche della tecnologia, e di He Looks Like You, in cui potevo scambiare imprevedibilità e autenticità, permettendomi di credere, per un istante, all’illusione suggerita da quelle immagini: che mio padre e mio figlio si fossero davvero incontrati.

Concludevo dicendo che, quando l’IA generativa fosse diventata più affidabile e prevedibile, probabilmente avrei perso quella curiosità che mi aveva spinto a sperimentare con essa.

Nel suo articolo, Ritchin sostiene che le immagini generate dall’IA siano diventate nel tempo più prevedibili, banali e simili alla fotografia stock. Nei primi anni, invece, lo colpiva proprio la capacità dei sistemi di produrre risultati inattesi, strani e talvolta quasi “rivelatori”. Secondo lui, paletti sempre più rigidi e modelli addestrati su una massa enorme di immagini convenzionali stanno contribuendo a rendere i risultati meno imprevedibili e meno originali. Da qui la domanda finale: se l’IA tende verso immagini sempre più standardizzate, i fotografi potrebbero reagire cercando maggiore complessità, ambiguità e originalità?

Questa osservazione, che condivido, in qualche modo mi fa pensare che quel momento di cui parlavo qualche anno fa sia già arrivato.

Non perché oggi l’intelligenza artificiale sia diventata davvero affidabile — continua a commettere errori, a inventare informazioni e a produrre risultati assurdi — ma perché, almeno nella generazione delle immagini, la sua imprevedibilità mi sembra sempre meno interessante. È un’imprevedibilità più controllata, addomesticata, racchiusa in un’estetica che tende a ripetersi.

La cosa che mi affascinava non era la possibilità di ottenere esattamente l’immagine che avevo in mente. Al contrario, era il momento in cui la macchina sembrava fraintendere la mia richiesta e restituirmi qualcosa che non avevo previsto. In quello scarto tra intenzione e risultato poteva accadere qualcosa. A volte niente di interessante, naturalmente (durante il lavoro su He Looks Like You passai decine di notti infruttuose e frustranti alla ricerca dell’immagine generata che mi interessava). Altre volte emergeva invece un’immagine capace di suggerire una direzione che io stesso non avevo immaginato.

Era forse lì che si trovava, almeno per me, la parte più stimolante del processo creativo: non nel controllo dello strumento, ma nella negoziazione con qualcosa che non riuscivo a controllare completamente. Questo non significa che abbia smesso di interessarmi all’intelligenza artificiale. Probabilmente sta semplicemente cambiando il motivo per cui mi interessa.

Sempre meno come macchina con cui produrre immagini e sempre più come fenomeno da osservare: per capire come sta modificando il nostro rapporto con la fotografia, con l’informazione, con la memoria e soprattutto con la fiducia che riponiamo nelle immagini.

Ed è forse qui che trovo particolarmente interessante la provocazione finale di Ritchin. Se l’IA è destinata a produrre con sempre maggiore facilità immagini formalmente perfette ma convenzionali, forse la fotografia non deve cercare di competere sullo stesso terreno.

Non è necessario che la fotografia diventi volutamente strana o imperfetta per distinguersi dall’IA; la sua forza potrebbe stare proprio nel confronto con una realtà che spesso non obbedisce al fotografo, che può impedirgli di raggiungere il risultato previsto ma anche offrirgli opportunità inimmaginabili. Per quanto possa studiare, prepararsi e immaginare il risultato, resta sempre la possibilità che qualcosa contraddica le sue aspettative, lo sorprenda e introduca nell’immagine un elemento di imprevedibilità. Forse è anche lì che la fotografia può ritrovare una parte del proprio valore: nella capacità di lasciare spazio a ciò che la realtà offre di inatteso e non previsto.

L'Immagine contesa. Fotogiornalismo, verità e disinformazione /  by Filippo Venturi

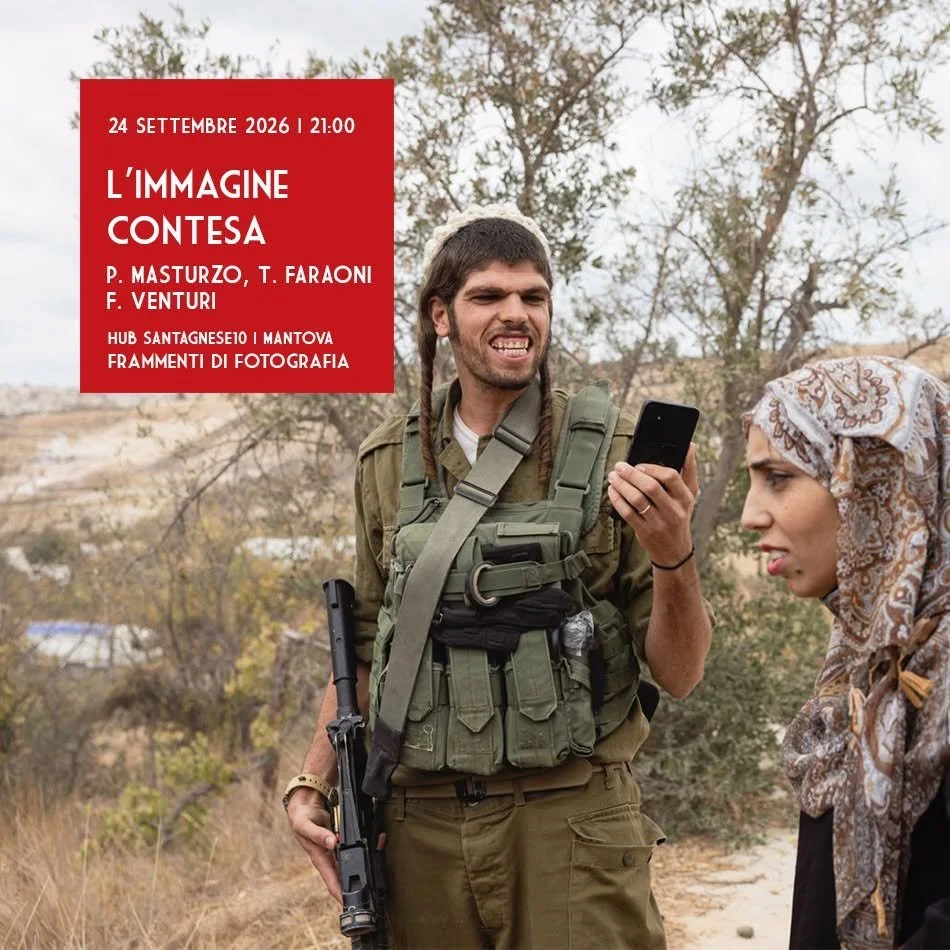
Pubblicata il 10 aprile 2026 sulla copertina de L'Espresso con il titolo “L’abuso”, la fotografia scattata da Pietro Masturzo il 12 ottobre 2025 a Idhna, in Cisgiordania, ha provocato polemiche internazionali e accuse di manipolazione.

Con Pietro Masturzo, Tiziana Faraoni e Filippo Venturi, l’incontro ricostruisce la vicenda e riflette su fotogiornalismo, responsabilità editoriale, verifica delle immagini e disinformazione nell’epoca dell’intelligenza artificiale.

Giovedì 24 settembre | ore 21:00
L'IMMAGINE CONTESA
Fotogiornalismo, verità e disinformazione.
Hub Santagnese10, Mantova.
A cura di Frammenti di fotografia.

Ingresso gratuito fino ad esaurimento posti


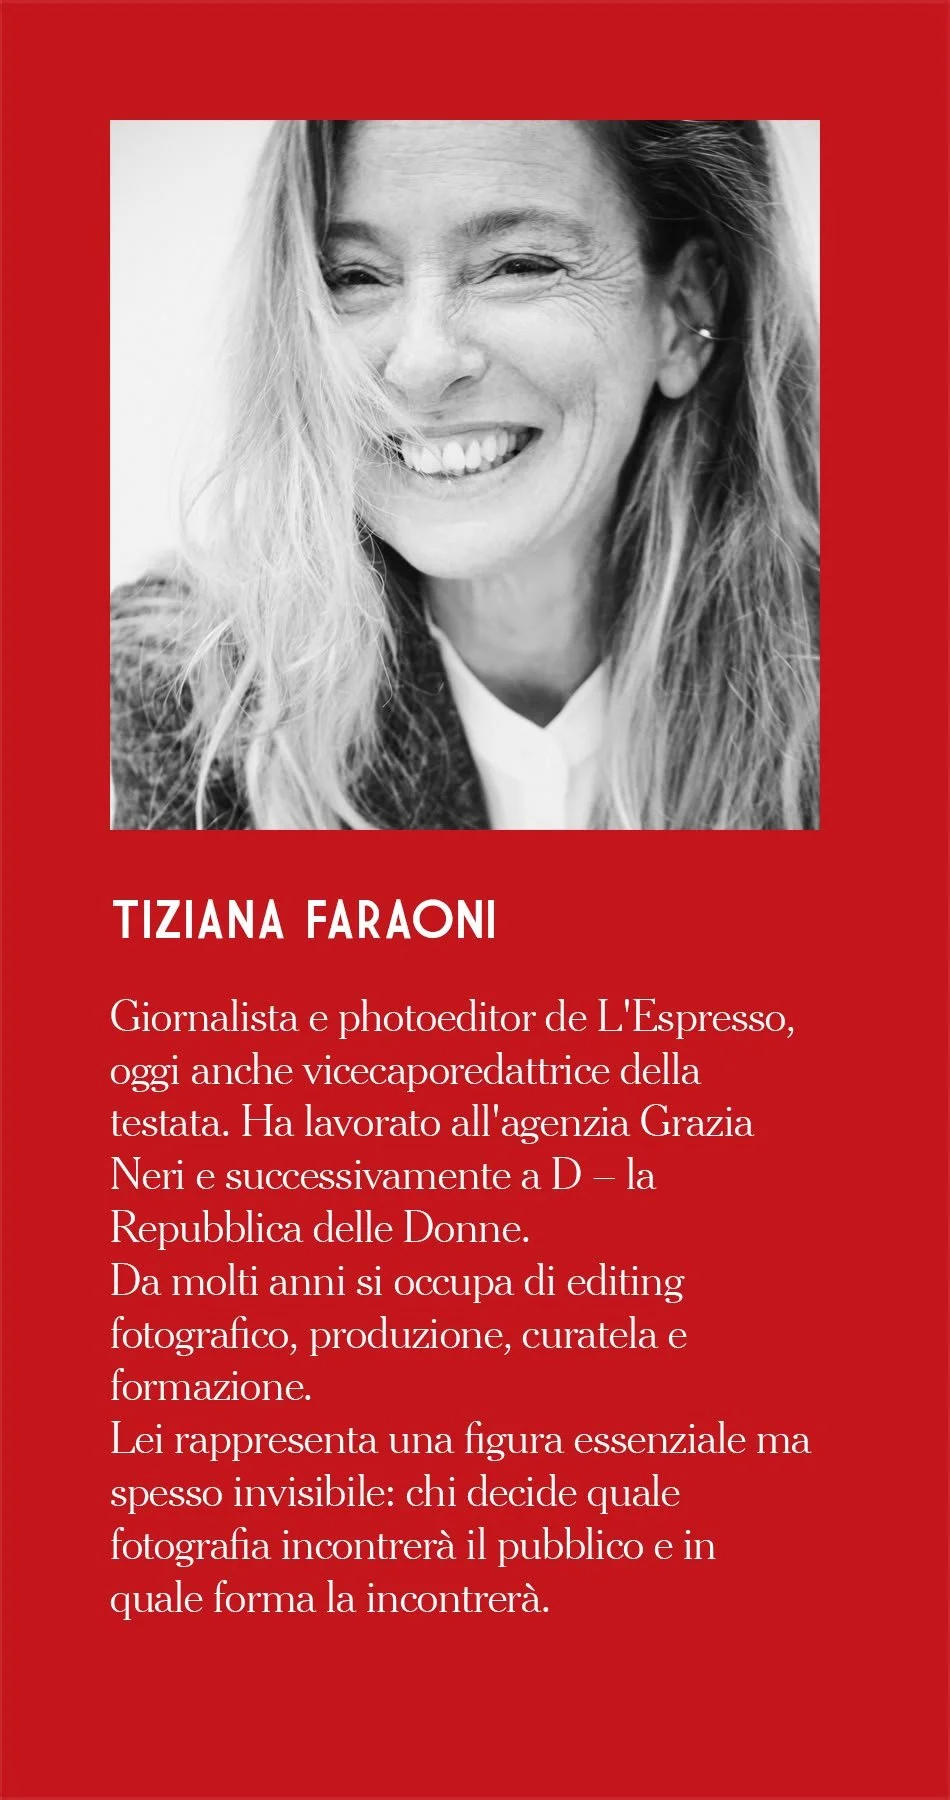
Tiziana Faraoni
Photo editor della rivista L’Espresso, curatrice e docente. Esperta di linguaggio fotografico e fotogiornalismo, seleziona e cura progetti visivi d’inchiesta, mostre ed edizioni fotografiche, promuovendo il racconto visivo della realtà sociale e politica contemporanea.

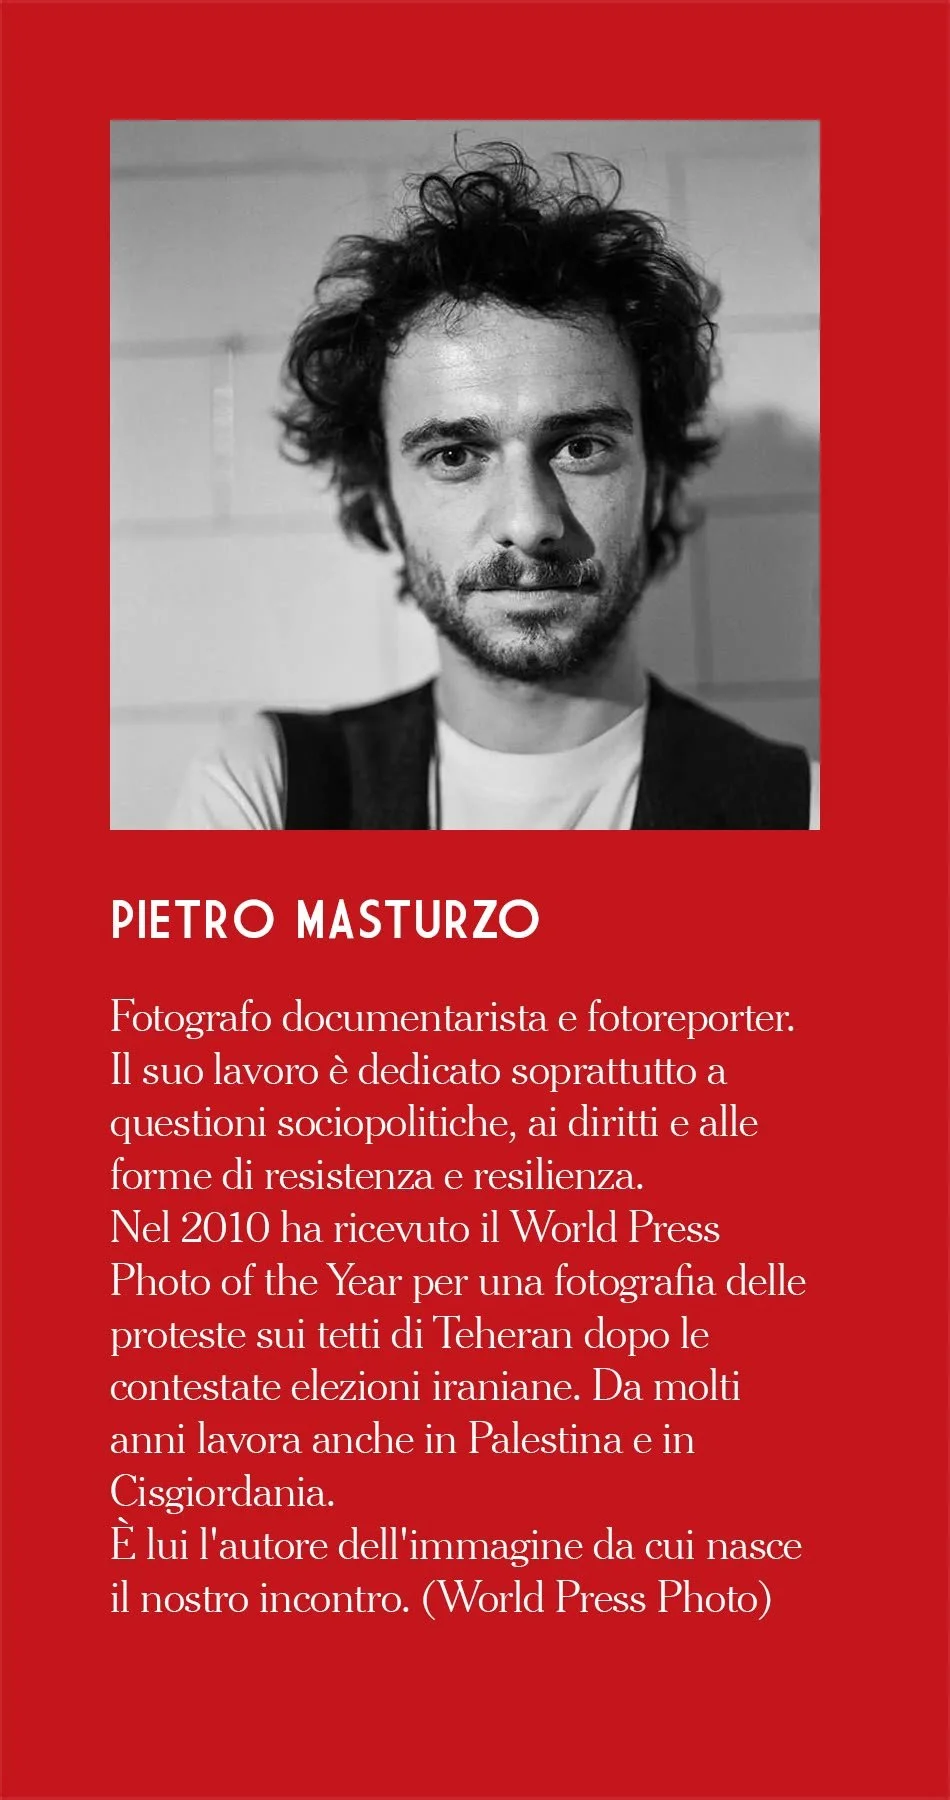
Pietro Masturzo
Fotoreporter di fama internazionale, vincitore del World Press Photo of the Year 2010. Documenta da anni conflitti, questioni socio-politiche e trasformazioni territoriali in tutto il mondo, collaborando con le principali testate giornalistiche italiane ed estere.

Filippo Venturi
Fotografo documentarista e docente. I suoi reportage, incentrati sulle grandi trasformazioni sociali e geopolitiche contemporanee, sono pubblicati su testate internazionali come National Geographic e Washington Post. È autore di mostre e progetti visivi pluripremiati.


Aggiornamento del 25/09/2026:

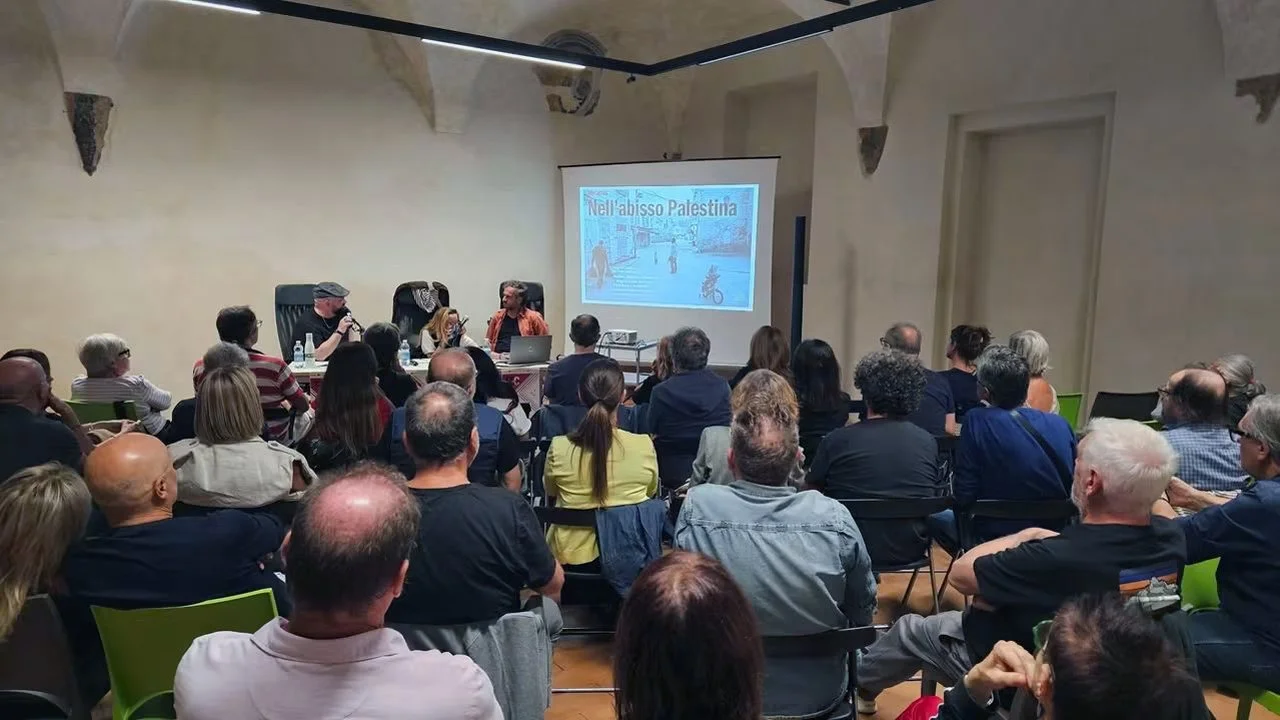
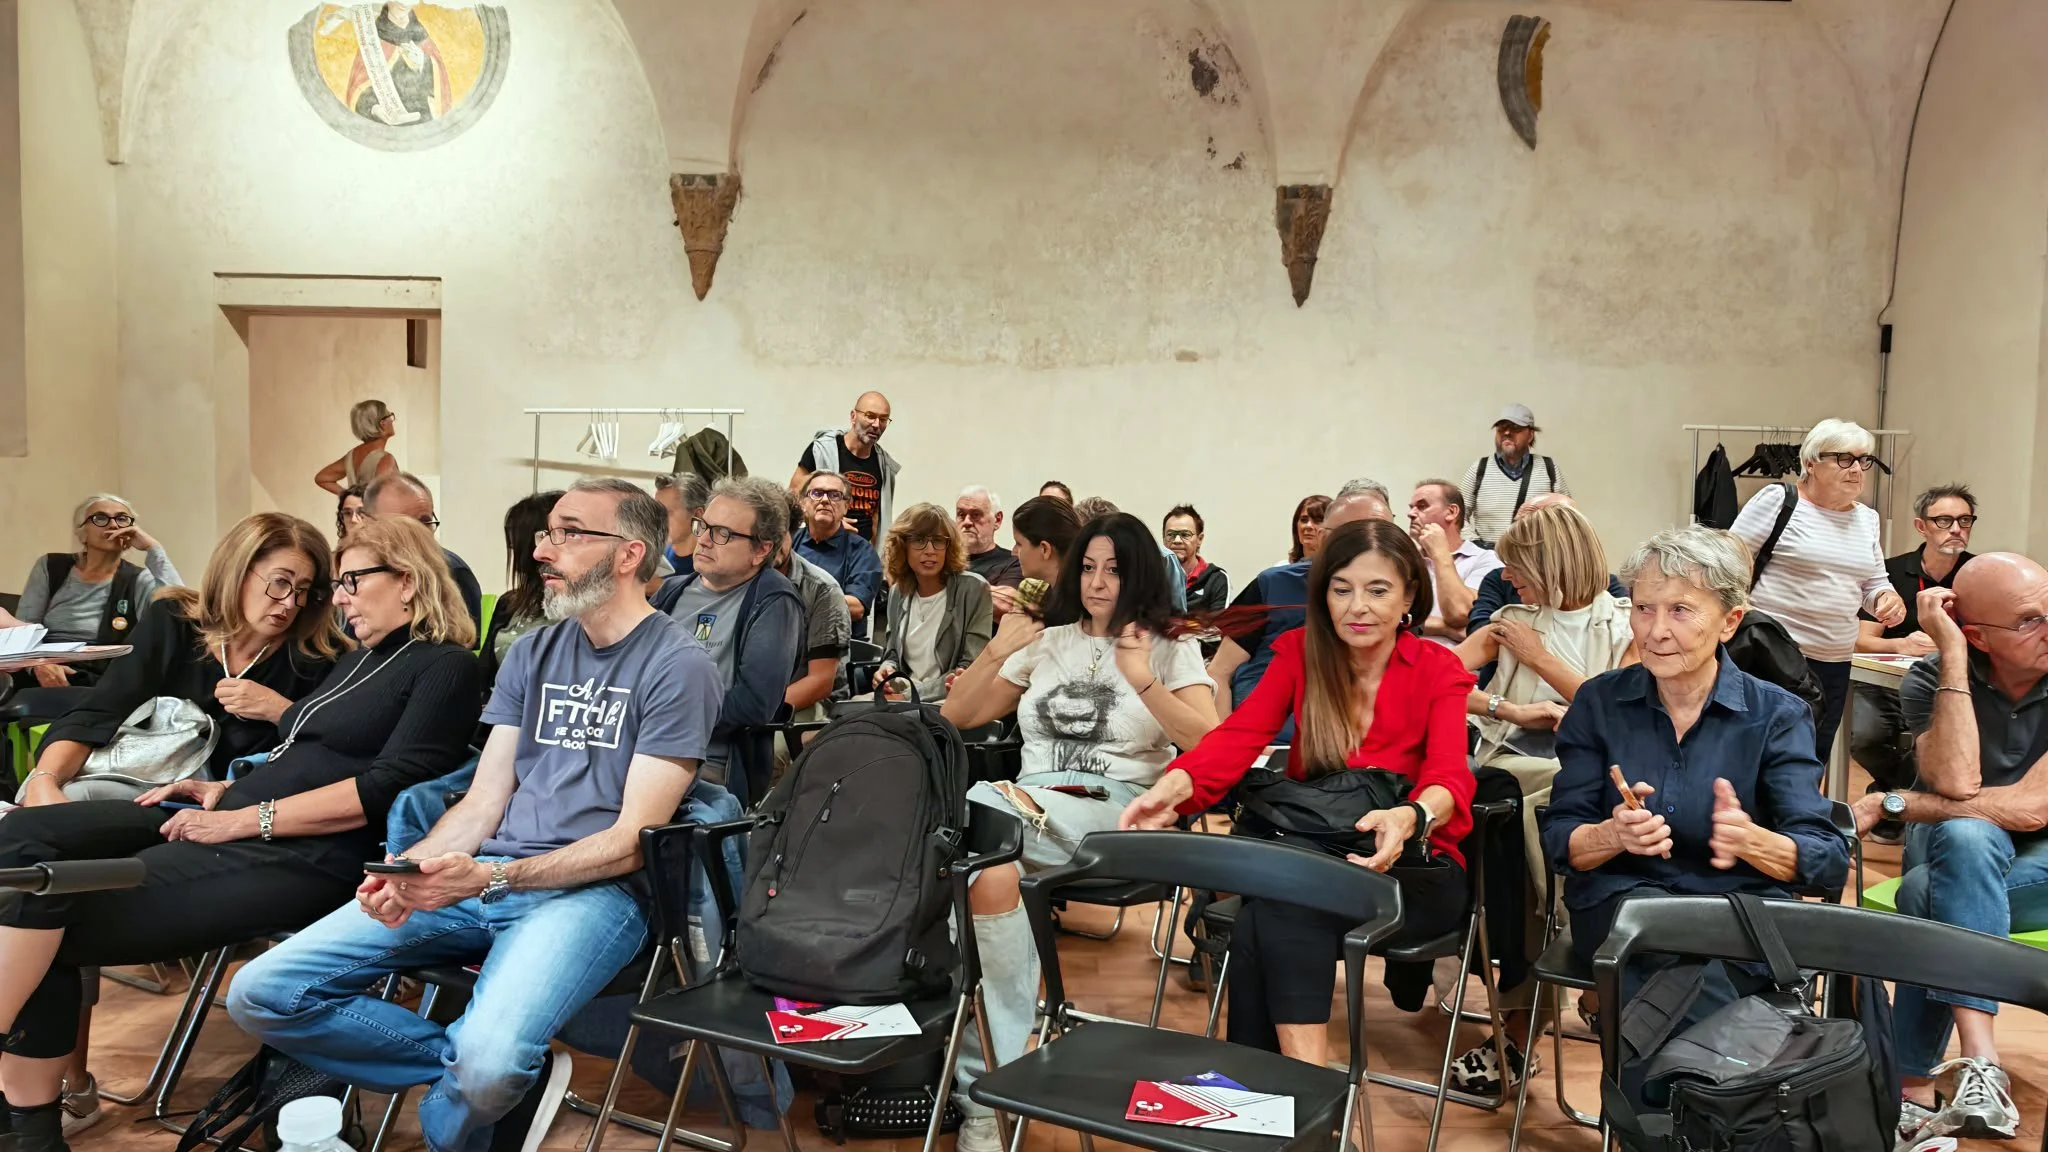
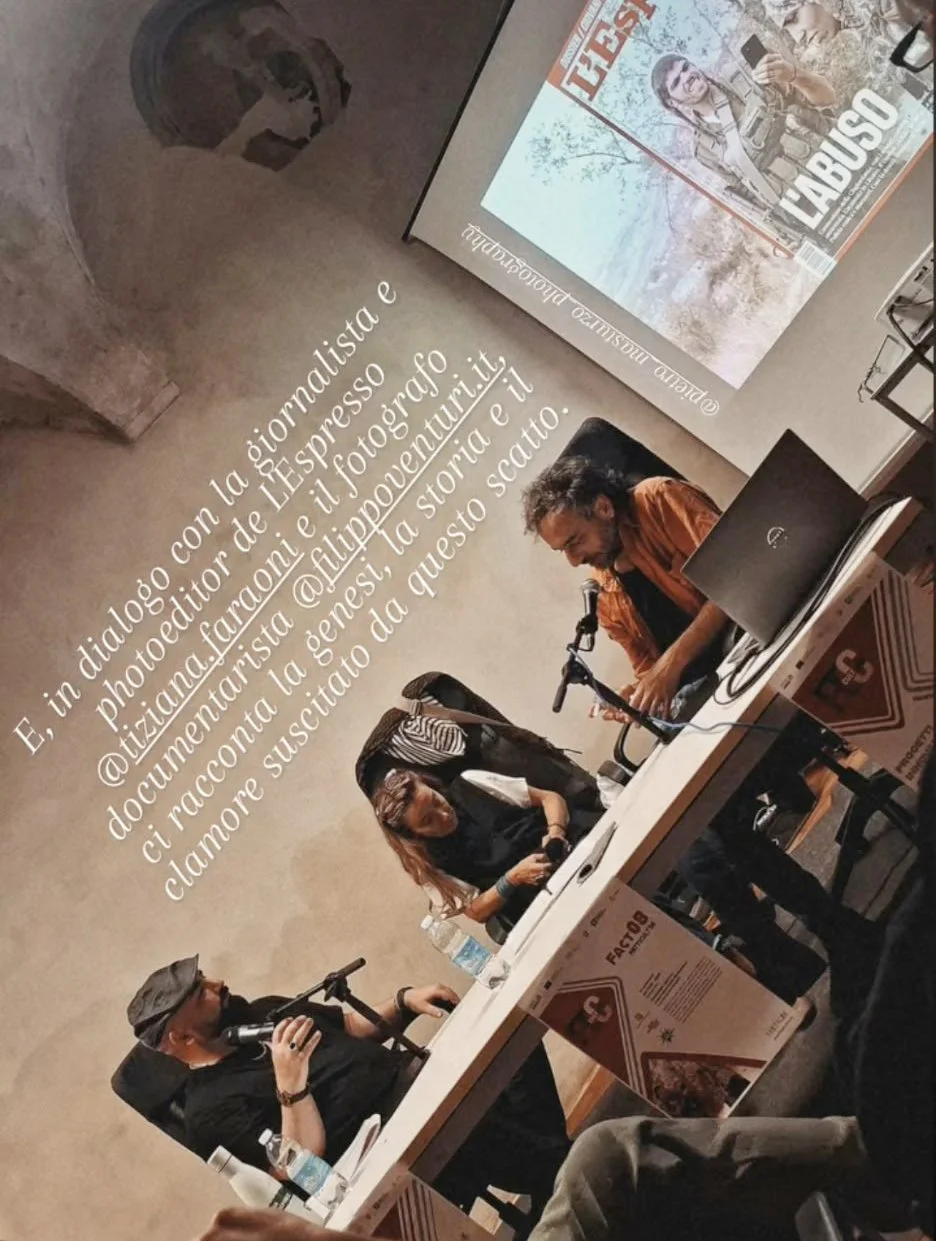
Qualche fotografia del piacevolissimo dialogo, che ho moderato, con Tiziana Faraoni (photoeditor de L’Espresso) e Pietro Masturzo (fotogiornalista) sulla celebre copertina della rivista intitolata “L’Abuso”, con la fotografia scattata da Pietro in Cisgiordania lo scorso 12 ottobre 2025, quando un gruppo di coloni israeliani armati, con il supporto di soldati, ha bloccato e minacciato i contadini palestinesi per impedire loro la raccolta delle olive.

E' stata l'occasione per approfondire il lavoro di Pietro in quei territori e la collaborazione con Tiziana, fino ad arrivare a quella copertina, che ha rappresentato un vero e proprio Atto di Resistenza.

Infine abbiamo ragionato sulle accuse e polemiche infondate che hanno travolto quella fotografia e su come è possibile orientarsi oggi nel flusso continuo di immagini che scorriamo.

Evento organizzato da Frammenti di fotografia di Mantova!

Il Nepal e l’alluvione di video generati con IA /  by Filippo Venturi

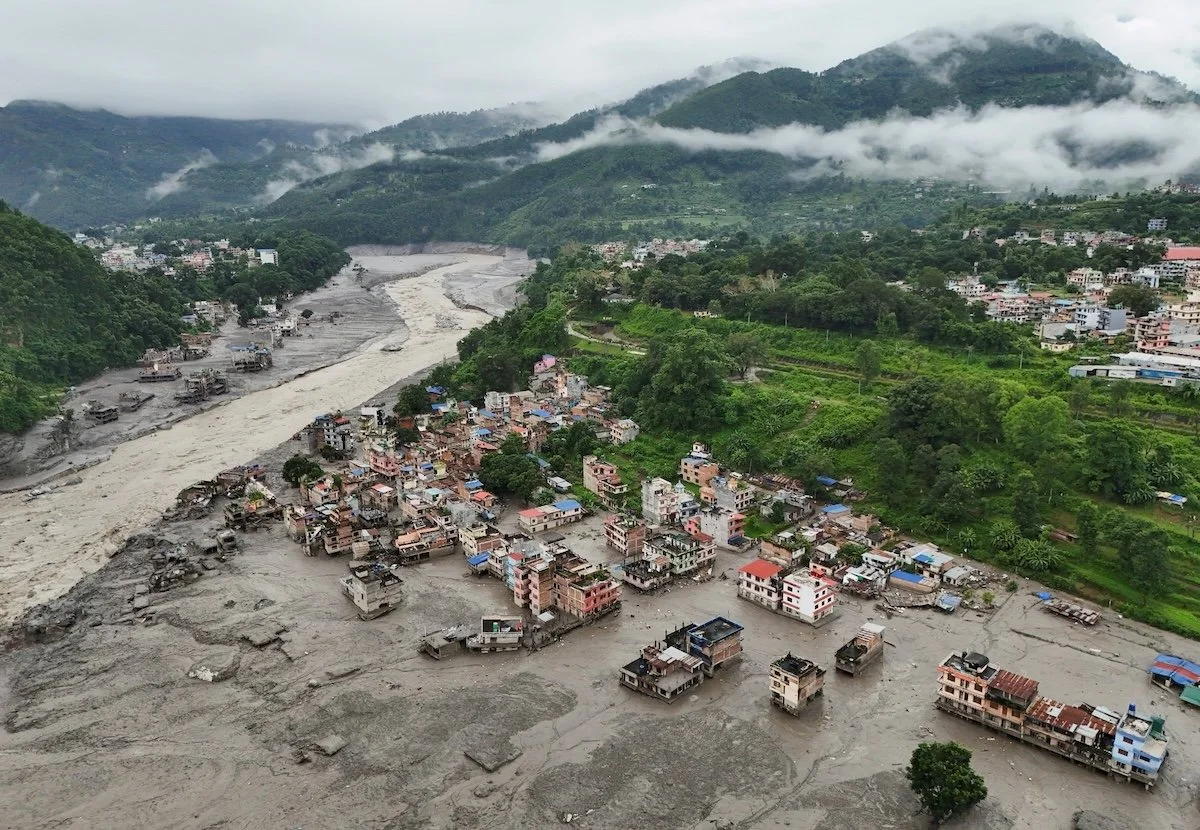
Edifici travolti dall'esondazione a Nuwakot, in Nepal, il 27 agosto 2026 (REUTERS/Navesh Chitrakar)

L’enorme alluvione che il 26 agosto ha colpito la valle del fiume Bhote Koshi, nella regione himalayana del Nepal al confine con il Tibet, è una tragedia enorme, con un bilancio ancora in aggiornamento di morti, dispersi e feriti, oltre alla distruzione di case e interi villaggi.

In questi giorni mi è capitato di vedere diversi video che documentavano quanto accaduto. Ancora più spesso mi è capitato di imbattermi in video falsi generati con l’intelligenza artificiale. Non mi è chiaro lo scopo degli autori. A naso potrei ipotizzare la volontà di attirare interazioni sui social network, attraverso stratagemmi ignobili.

Il fenomeno della disinformazione, naturalmente, esisteva già prima dell’intelligenza artificiale. Fotografie decontestualizzate, vecchi video riciclati e immagini manipolate accompagnano da molti anni guerre, elezioni e catastrofi naturali. Quello che sta cambiando è però la scala del fenomeno. Oggi è possibile produrre in pochi minuti un numero potenzialmente enorme di fotografie e video completamente falsi ma sufficientemente credibili da confondersi, almeno durante una visione veloce sui social, con la documentazione autentica.

Nel caso in questione, si è raggiunto un tale livello di saturazione di contenuti falsi, manipolati o decontestualizzati che il governo nepalese ha deciso di incontrare i rappresentanti locali di Meta e TikTok per sollecitare interventi contro quattro categorie di contenuti: video/immagini generati con IA e vecchi contenuti ripresentati come attuali, oltre a immagini cruente e falsi QR code per raccogliere donazioni.

Le piattaforme dispongono già di referenti attraverso i quali il governo può segnalare i post, ma secondo l'autorità nepalese impiegano dalle 24 alle 48 ore a intervenire e quel lasso di tempo è sufficiente a renderli virali, a fare disinformazione e a commettere anche truffe e abusi.

Nell’articolo “In disaster aftermath, Nepal battles a flood of misinformation” (qui il link), pubblicato dal Kathmandu Post, viene raccontata proprio questa seconda catastrofe, quella informativa, che si è sovrapposta alla prima.

Ora, proviamo a immaginare se un fenomeno di questa intensità si verificasse contemporaneamente su più grandi eventi di attualità. Come il referendum in Islanda sulla ripresa dei negoziati di adesione all’Unione Europea, alluvioni e grandinate in Italia, gli attacchi con droni e missili in Ucraina, Palestina o Russia, ecc.

Per ognuno di questi eventi potrebbero cominciare a circolare, nel giro di poche ore, decine o centinaia di fotografie e video falsi, mescolati a quelli autentici.

Già oggi, con bias e bolle social, si è visto quanto sia facile dissociarsi dalla realtà, ma nello scenario immaginato sarebbe ancora più semplice perdere completamente la bussola e, con essa, la fiducia nell’informazione.


𝗔 𝘄𝗮𝘃𝗲 𝗼𝗳 𝗔𝗜-𝗴𝗲𝗻𝗲𝗿𝗮𝘁𝗲𝗱 𝘃𝗶𝗱𝗲𝗼𝘀

The devastating flood that struck the Bhote Koshi River valley on 26 August, in Nepal’s Himalayan region along the border with Tibet, is already an enormous tragedy, with the number of dead, missing and injured still being updated, as well as homes and entire villages destroyed.

Over the past few days, I have come across several videos documenting what happened. Even more often, however, I have encountered fake videos generated using artificial intelligence. It is not entirely clear to me what those creating them are trying to achieve. At a guess, I would say it is largely an attempt to attract engagement on social media through particularly disgraceful tactics.

Disinformation, of course, existed long before artificial intelligence. Photographs taken out of context, old videos recycled as current footage and manipulated images have accompanied wars, elections and natural disasters for many years. What is changing, however, is the scale of the phenomenon. Today, it is possible to produce, within minutes, a potentially enormous number of completely fabricated photographs and videos that are nevertheless credible enough to be mistaken, at least during a quick scroll through social media, for authentic documentation.

In this particular case, the saturation of false, manipulated or decontextualised content has reached such a level that the Nepalese government decided to meet local representatives of Meta and TikTok to urge them to take action against four categories of content: AI-generated videos and images, old material presented as current, graphic images, and fake QR codes used to solicit donations.

The platforms already have designated contacts through whom the government can report problematic posts, but according to the Nepalese authorities it can take between 24 and 48 hours for them to act. That is more than enough time for false content to go viral, spread misinformation and also be used for scams and other abuses.

The article “In disaster aftermath, Nepal battles a flood of misinformation” (link in the comments), published by the Kathmandu Post, describes precisely this second disaster: the information disaster that has unfolded on top of the first.

Now imagine if a phenomenon of this intensity were to occur simultaneously around several major news events: the referendum in Iceland on resuming negotiations to join the European Union, floods and hailstorms in Italy, drone and missile attacks in Ukraine, Palestine or Russia, and so on.

For each of these events, within the space of just a few hours, dozens or hundreds of false photographs and videos could begin circulating alongside authentic ones.

Even today, with confirmation biases and social media bubbles, we have already seen how easy it can be to become increasingly detached from reality. In the scenario described above, it would become even easier to lose our bearings completely — and, with them, our trust in information itself.

Sheep in the Box. Il sogno di sottrarre qualcuno alla morte /  by Filippo Venturi

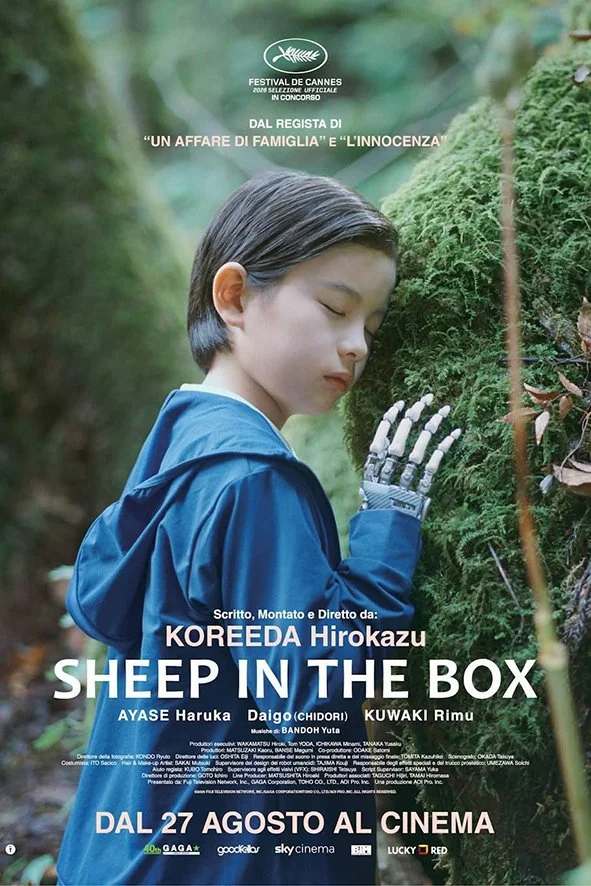
Ieri ho visto “Sheep in the Box”, il nuovo film di Hirokazu Kore-eda, regista giapponese che apprezzo soprattutto per la sensibilità con cui riesce a raccontare i rapporti familiari.

Pochi giorni fa avevo scritto di un altro suo film, “Father & Son”, soffermandomi in particolare su una scena in cui la fotografia assumeva un ruolo decisivo (per chi è curioso, qui il link).

In quel film due famiglie scoprono, sei anni dopo la nascita dei rispettivi figli, che i bambini sono stati scambiati alla nascita in ospedale. Devono quindi decidere se continuare a vivere con il figlio che hanno cresciuto oppure ricongiungersi con quello biologico. Kore-eda pone una domanda solo apparentemente semplice. Cosa rende qualcuno nostro figlio? Il sangue? La somiglianza? Il tempo trascorso insieme? I ricordi? L'affetto?

Con “Sheep in the Box”, il regista sembra riprendere quella domanda, spostandola in un futuro prossimo e introducendo un elemento nuovo: l'intelligenza artificiale. I coniugi Kōmoto hanno perso il loro figlio Kakeru, di sette anni. Due anni dopo ricevono una proposta da REbirth, un'azienda che offre loro un androide basato sull'intelligenza artificiale, realizzato con le sembianze e la voce del bambino scomparso. La coppia accetta.

In “Father & Son” il regista mostrava che la biologia, da sola, non è sufficiente a definire un figlio. In “Sheep in the Box” sembra suggerire che nemmeno la perfetta riproduzione dell'aspetto e della voce di una persona può essere sufficiente a restituircela.

Una persona non coincide né con il proprio patrimonio genetico né con la propria apparenza, ma è anche (e forse soprattutto) la storia delle relazioni che ha costruito con gli altri.

Nel 2023 ho realizzato “He Looks Like You”, un progetto nel quale ho unito fotografie autentiche e immagini generate con l’IA per rappresentare l’incontro fra mio padre Giorgio e mio figlio Ulisse. Si trattava di false fotografie di famiglia, dato che mio padre è morto cinque anni prima della nascita di mio figlio e quindi i due non si sono mai potuti conoscere. Erano immagini create nel tentativo, attraverso arte e tecnologia, di trovare una forma di consolazione e di accedere a luoghi che nella realtà erano e resteranno irraggiungibili.

Guardando “Sheep in the Box” ho inevitabilmente ripensato a quel lavoro. Kore-eda porta l'esperimento ancora un passo più avanti, immaginando una situazione nella quale la persona scomparsa può tornare presente, occupare nuovamente uno spazio nella casa, abbracciarci e creare nuove esperienze.

Una simulazione può produrre emozioni autentiche senza che ciò che rappresenta sia autentico. Così come le fotografie di “He Looks Like You” sono false, ma non è necessariamente falso quello che provocano in chi le guarda, a partire da me.

Allo stesso modo il Kakeru artificiale non è il bambino morto, ma gli affetti, le paure, la tenerezza o il dolore che genera nei suoi genitori sono reali. Naturalmente i genitori sono al corrente della differenza, ma questa consapevolezza tende rapidamente a sfumare mentre vivono (o rivivono) determinati sentimenti.

Il titolo del film offre una chiave per capirlo. “Sheep in the Box” rimanda infatti a “Il Piccolo Principe” di Antoine de Saint-Exupéry. Quando il Piccolo Principe chiede al pilota di disegnargli una pecora e continua a non essere soddisfatto dei suoi tentativi, il pilota finisce per disegnare semplicemente una scatola, dicendogli che la pecora che desidera si trova al suo interno. E questa operazione viene compiuta dai genitori con l’androide. Sono loro a vederci il figlio dentro.

Quando chiediamo a un software di costruire l'immagine di qualcosa che non è mai accaduto (due familiari che non si sono mai incontrati, un evento mai avvenuto, ecc.) quell'immagine non contiene realmente quel passato. Siamo noi a riempirla.

 “Sheep in the Box” non mi ha però soddisfatto completamente. Il film mette molta carne al fuoco: il lutto, l'identità, la memoria, la famiglia, la sostituibilità delle persone, il rapporto fra uomini e macchine, l'autonomia delle intelligenze artificiali, il confine fra imitazione ed esperienza. Molti di questi elementi non vengono però approfonditi o sviluppati in modo esauriente, almeno per me.

La delicatezza di Kore-eda rimane invece intatta. La tecnologia non viene rappresentata come una minaccia che conquisterà il mondo, né il film sembra particolarmente interessato a stabilire se l'intelligenza artificiale sia buona o cattiva. Kore-eda continua a fare quello che ha sempre fatto nel suo cinema. Osservare una famiglia.

Terminata la proiezione, ne ho discusso a lungo e in modo molto coinvolgente con gli amici con cui ero andato al cinema. Poi ho continuato a pensarci, ho fatto alcune ricerche online e inevitabilmente ho collegato il film ad altre esperienze e riflessioni personali. Ci sono film che terminano insieme ai titoli di coda. In questo caso qualcosa ha continuato a ronzarmi dentro anche dopo.

Migranti di Ceuta e intelligenza artificiale /  by Filippo Venturi

Una fotografia senza contesto, una notizia contraddittoria e il sospetto di un'immagine generata dall'IA

In questi giorni in cui sono in ferie, avevo notato un’immagine un po’ sospetta e mi sarei aspettato nei giorni successivi di leggere qualche verifica di fact-checker “noti”, ma non è accaduto.

Il 7 agosto il quotidiano Secolo d’Italia pubblica il seguente articolo:
”Schengen, 15 irregolari provenienti dalla Spagna respinti negli aeroporti italiani: i fatti danno ragione al governo”, pubblicando a corredo quella che sembra una immagine d’archivio, con due poliziotti che svolgono dei controlli e la didascalia ”Foto: Ansa / Telenews (1 agosto 2026)”.

La fotografia non presenta particolari anomalie o curiosità, ma l’articolo al suo interno sembra contraddire il titolo perché dice “A riferire questo primo risultato è stata La Verità, facendo riferimento a fermi avvenuti in cinque diversi aeroporti: Linate, Malpensa, Bologna, Torino e Orio al Serio“. Non sono riuscito a reperire l'articolo originale de La Verità, quindi non posso verificare direttamente il contesto e la formulazione della notizia, ma l’aspetto più importante è che si tratta di fermi avvenuti in 5 aeroporti diversi, cosa che sarà importante in seguito.

In seguito l’articolo dice “Si tratta di extracomunitari privi di un permesso per circolare nel territorio italiano. Non è stato ancora possibile stabilire se fra questi 15 stranieri irregolari ci fossero anche immigrati passati dall’enclave spagnola in Africa“, il che fa dubitare sulla correttezza del titolo.

La notizia è stata condivisa su Facebook dalla pagina ufficiale di Fratelli d’Italia, utilizzando una immagine che mostra 13 migranti fermati da 4 poliziotti.

L’immagine presenta alcune anomalie:
1) L’immagine è priva di didascalia o comunque di un testo che la contestualizzi.
2) La scritta Polizia sulla schiena del poliziotto al centro sembra deformata, così come la scritta subito sotto, ricordando alcuni difetti tipici delle immagini generate con intelligenza artificiale (IA).
3) Anche l'abbigliamento dei presenti appare, a prima vista, poco compatibile con le temperature del periodo; si tratta tuttavia di un elemento secondario, così come altri dettagli presenti.
4) Se i 15 respingimenti sono avvenuti in cinque aeroporti diversi, non è però possibile stabilire che le 13 persone mostrate nell’immagine corrispondano a una parte di quei 15 casi. In assenza di una didascalia o di una fonte che identifichi l'immagine, il collegamento con la notizia rimane quindi non dimostrato.

Ci sono quindi vari livelli in cui questa notizia presenta delle criticità:
1) La notizia non dimostra che i 15 respinti provenissero da Ceuta — Prendendo per buona la notizia dei 15 fermi, è il quotidiano stesso a dire che non è stato possibile verificare quanti di questi 15 migranti provenissero da Ceuta. Appare un po’ affrettato quindi riconoscere dei meriti al governo circa la temporanea sospensione della libera circolazione Schengen nei collegamenti con la Spagna, senza dati verificati.
2) L’immagine non è contestualizzata e non viene fornita una fonte — L’immagine usata su Facebook da Fratelli d’Italia (e che non ho trovato altrove, se non dagli utenti che l’hanno condivisa partendo dal post Facebook) solleva qualche dubbio: prima di tutto non è presentata con una didascalia o descrizione, ma è semplicemente accostata alla notizia dei 15 fermi, lasciando quindi pensare che sia relativa a quell’evento. Il problema però è che presenta alcune anomalie tipiche dell’IA, come la scritta POLIZIA deformata e il testo subito sotto.
3) L'ipotesi IA — A parere personale, potrebbe essere una fotografia scelta da un altro contesto oppure, più probabilmente, l’ennesimo caso di immagine generata utilizzata a scopo illustrativo di un evento realmente accaduto (i 15 fermi, ma la notizia stessa si contraddice fra titolo e articolo, non rendendo possibile trarre conclusioni sicure), ma scelta o costruita in modo da risultare più efficace sul piano comunicativo e più persuasiva nei confronti del pubblico. Una immagine fotografica apocrifa (di cui avevo già parlato qui).

Immagine condivisa sulla pagina Facebook di Fratelli d’Italia, che riprende la notizia del quotidiano Secolo d’Italia

Pagina del quotidiano Secolo d’Italia, che usa una fotografia Ansa a corredo dell’articolo.

Immagini fotografiche apocrife /  by Filippo Venturi

Immagine generata con intelligenza artificiale e diventata virale sui social nell’estate del 2026. Raffigura un agente marocchino nell’atto di lanciare una grossa pietra contro un uomo indicato in alcune pubblicazioni come un migrante di ritorno da Ceuta. Secondo i controlli di Verificat, l’immagine sintetica ricostruisce una scena molto simile a quella documentata da un video ripreso da lontano a Fnideq, sul lato marocchino del confine con Ceuta. La scena si inserisce nella crisi migratoria del 30 e 31 luglio, quando decine di migliaia di persone entrarono irregolarmente a Ceuta dal Marocco. Nei giorni immediatamente successivi la grande maggioranza tornò indietro: secondo la stima comunicata il 4 agosto dal ministro dell’Interno spagnolo, circa 70.000 delle 72.000 persone entrate avevano già fatto ritorno in Marocco.

Questa immagine di un agente di polizia che lancia una pietra contro una persona, che secondo alcune fonti sarebbe un migrante che cerca di tornare in Marocco da Ceuta, è diventata virale sui social media in queste ore perché raffigura un momento terribile che diventa anche il simbolo di una questione che è ormai da anni al centro dell'attualità, cioè il fenomeno migratorio.

Fenomeno che, da una parte, viene raccontato come un’invasione, presentando il gesto dell’uomo che solleva la pietra come la reazione esasperata di chi difende un confine; dall’altra, come l’esibizione di una forza sproporzionata contro persone vulnerabili, talvolta utilizzata dai governi per alimentare la paura e distogliere l’attenzione da altri problemi.

Questa immagine, però, è stata generata con l’intelligenza artificiale, come rilevato da alcune testate e organizzazioni di fact-checking, tra cui Verificat in un articolo pubblicato da La Vanguardia. Già a un primo sguardo presentava alcuni elementi poco convincenti, ma da tempo il semplice sospetto non è più sufficiente e occorre verificare la provenienza dei contenuti e cercare riscontri attendibili.

L’episodio raffigurato sembra essere realmente avvenuto ed è documentato da un video ripreso da lontano, sul quale al momento non sono emersi elementi per dubitare della sua autenticità. L’immagine virale non è quindi una fotografia autentica né un semplice fotogramma del filmato, ma una ricostruzione generativa della scena, presumibilmente realizzata utilizzando come riferimento un fotogramma estratto dal video.

Confronto tra un fotogramma del video circolato sui social, a sinistra, e l’immagine generata con intelligenza artificiale, a destra. La ricostruzione conserva la struttura fondamentale della scena e il gesto dell’agente, ma trasforma un’immagine distante e poco definita in una rappresentazione nitida, immediatamente leggibile e visivamente più drammatica.

È proprio questa sovrapposizione tra la falsità dell’immagine e la verità dell’evento a rendere il fenomeno particolarmente insidioso. La semplice opposizione tra vero e falso diventa insufficiente a descrivere ciò che accade: ciò che vediamo non documenta il fatto, ma nemmeno lo inventa necessariamente. Ne produce invece una rappresentazione plausibile, costruita a posteriori, che può finire per sostituirsi, nella memoria collettiva, alle immagini realmente disponibili.

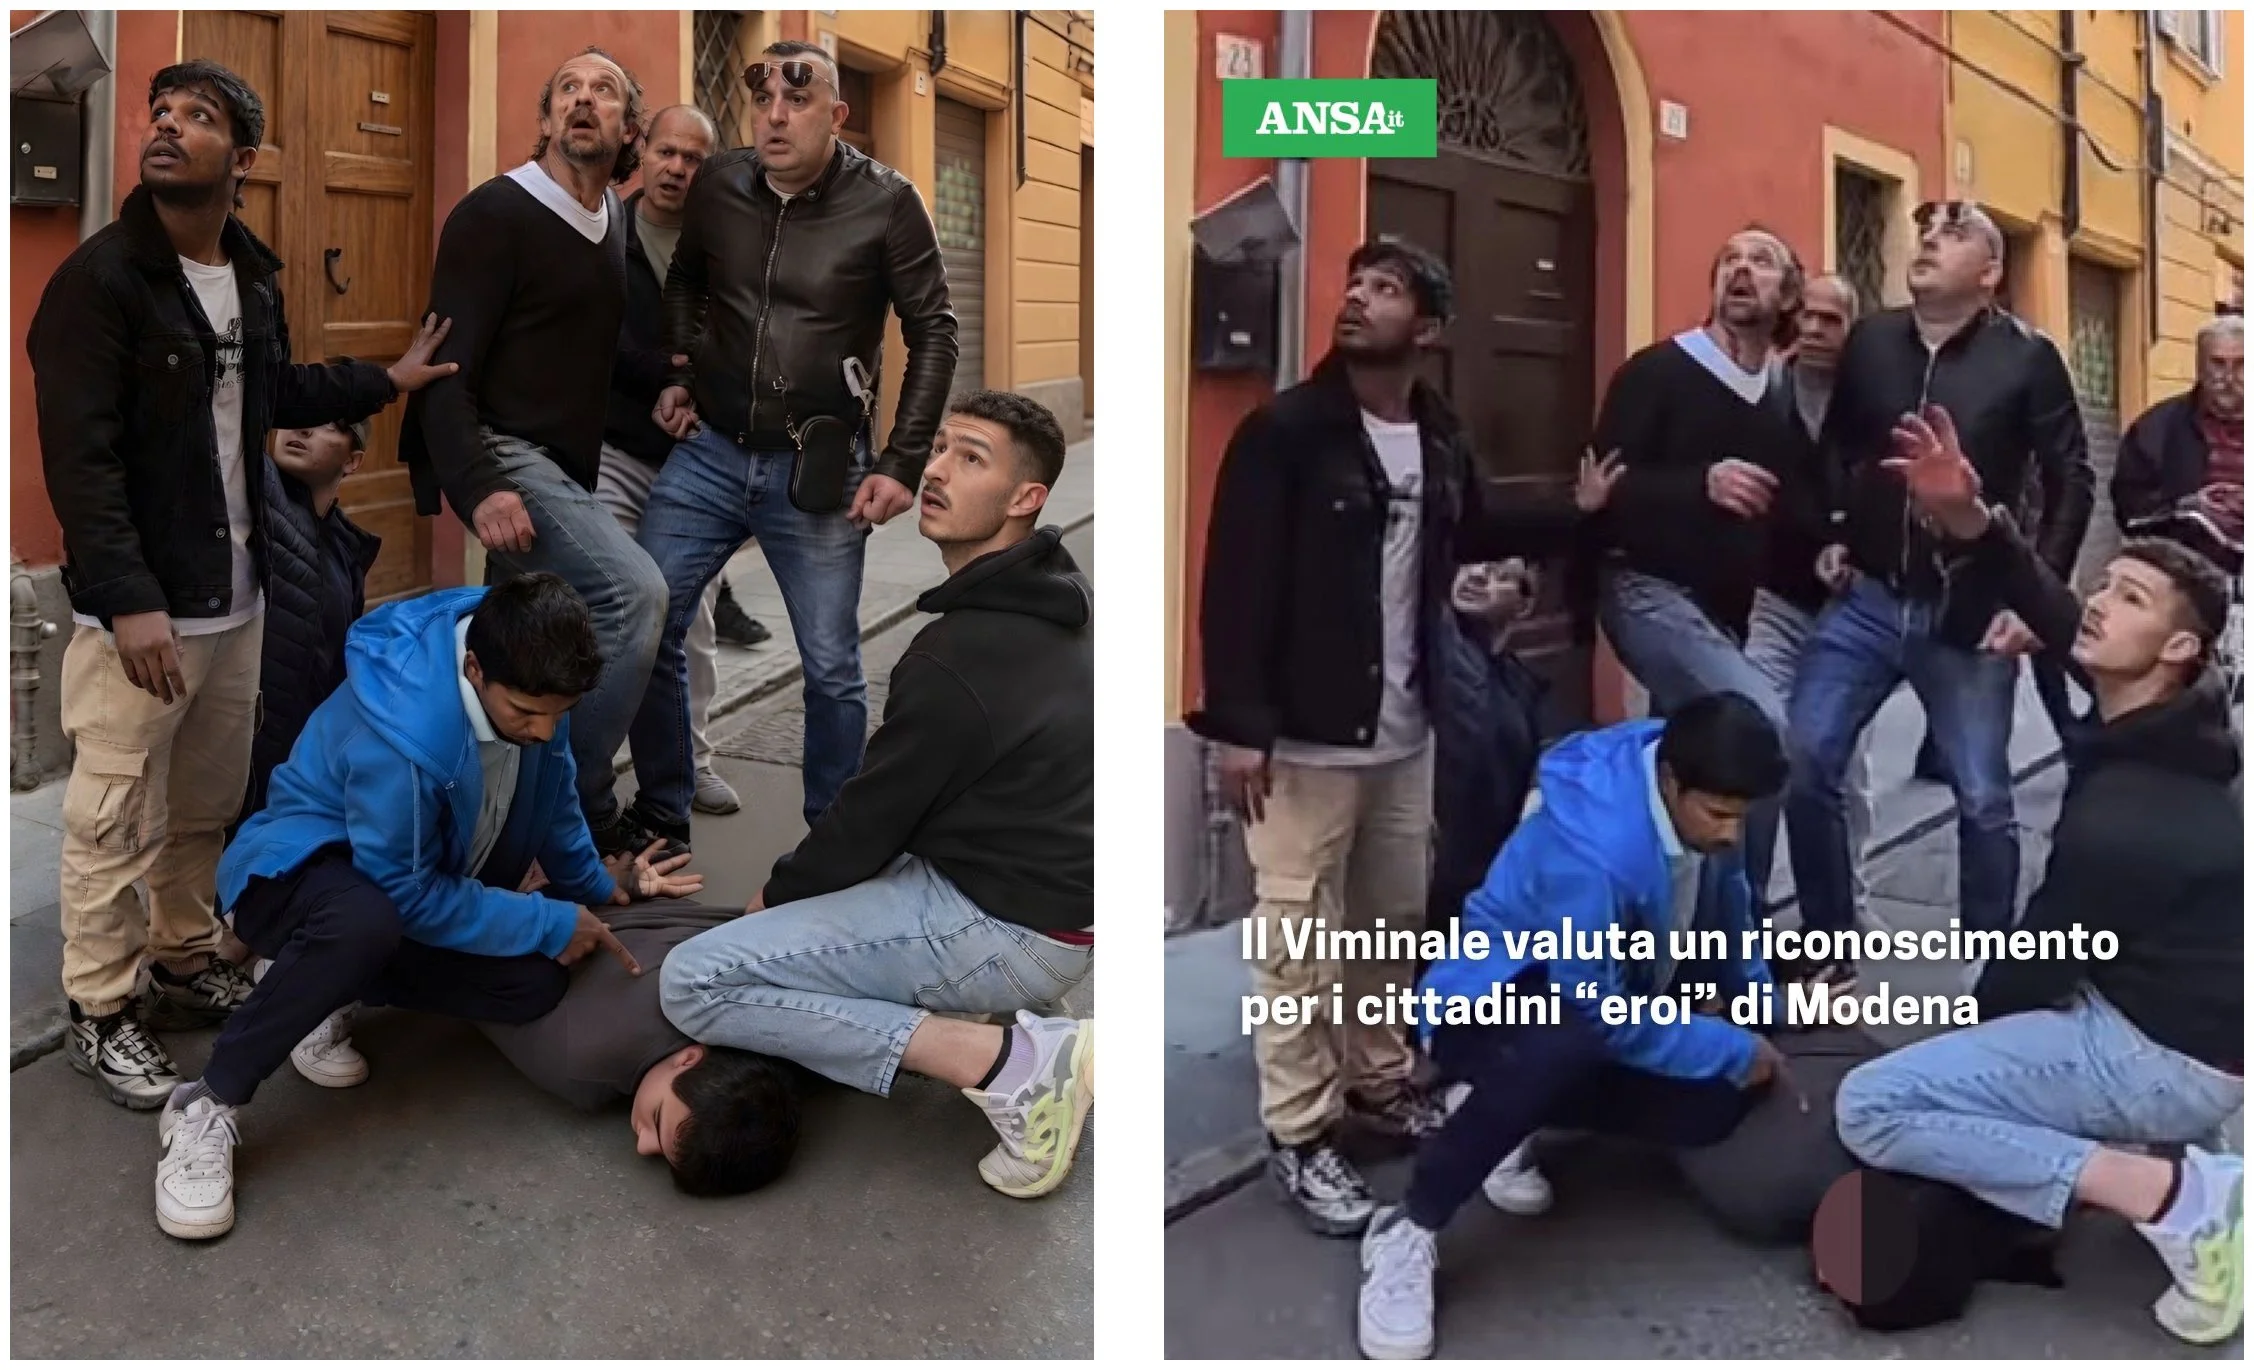
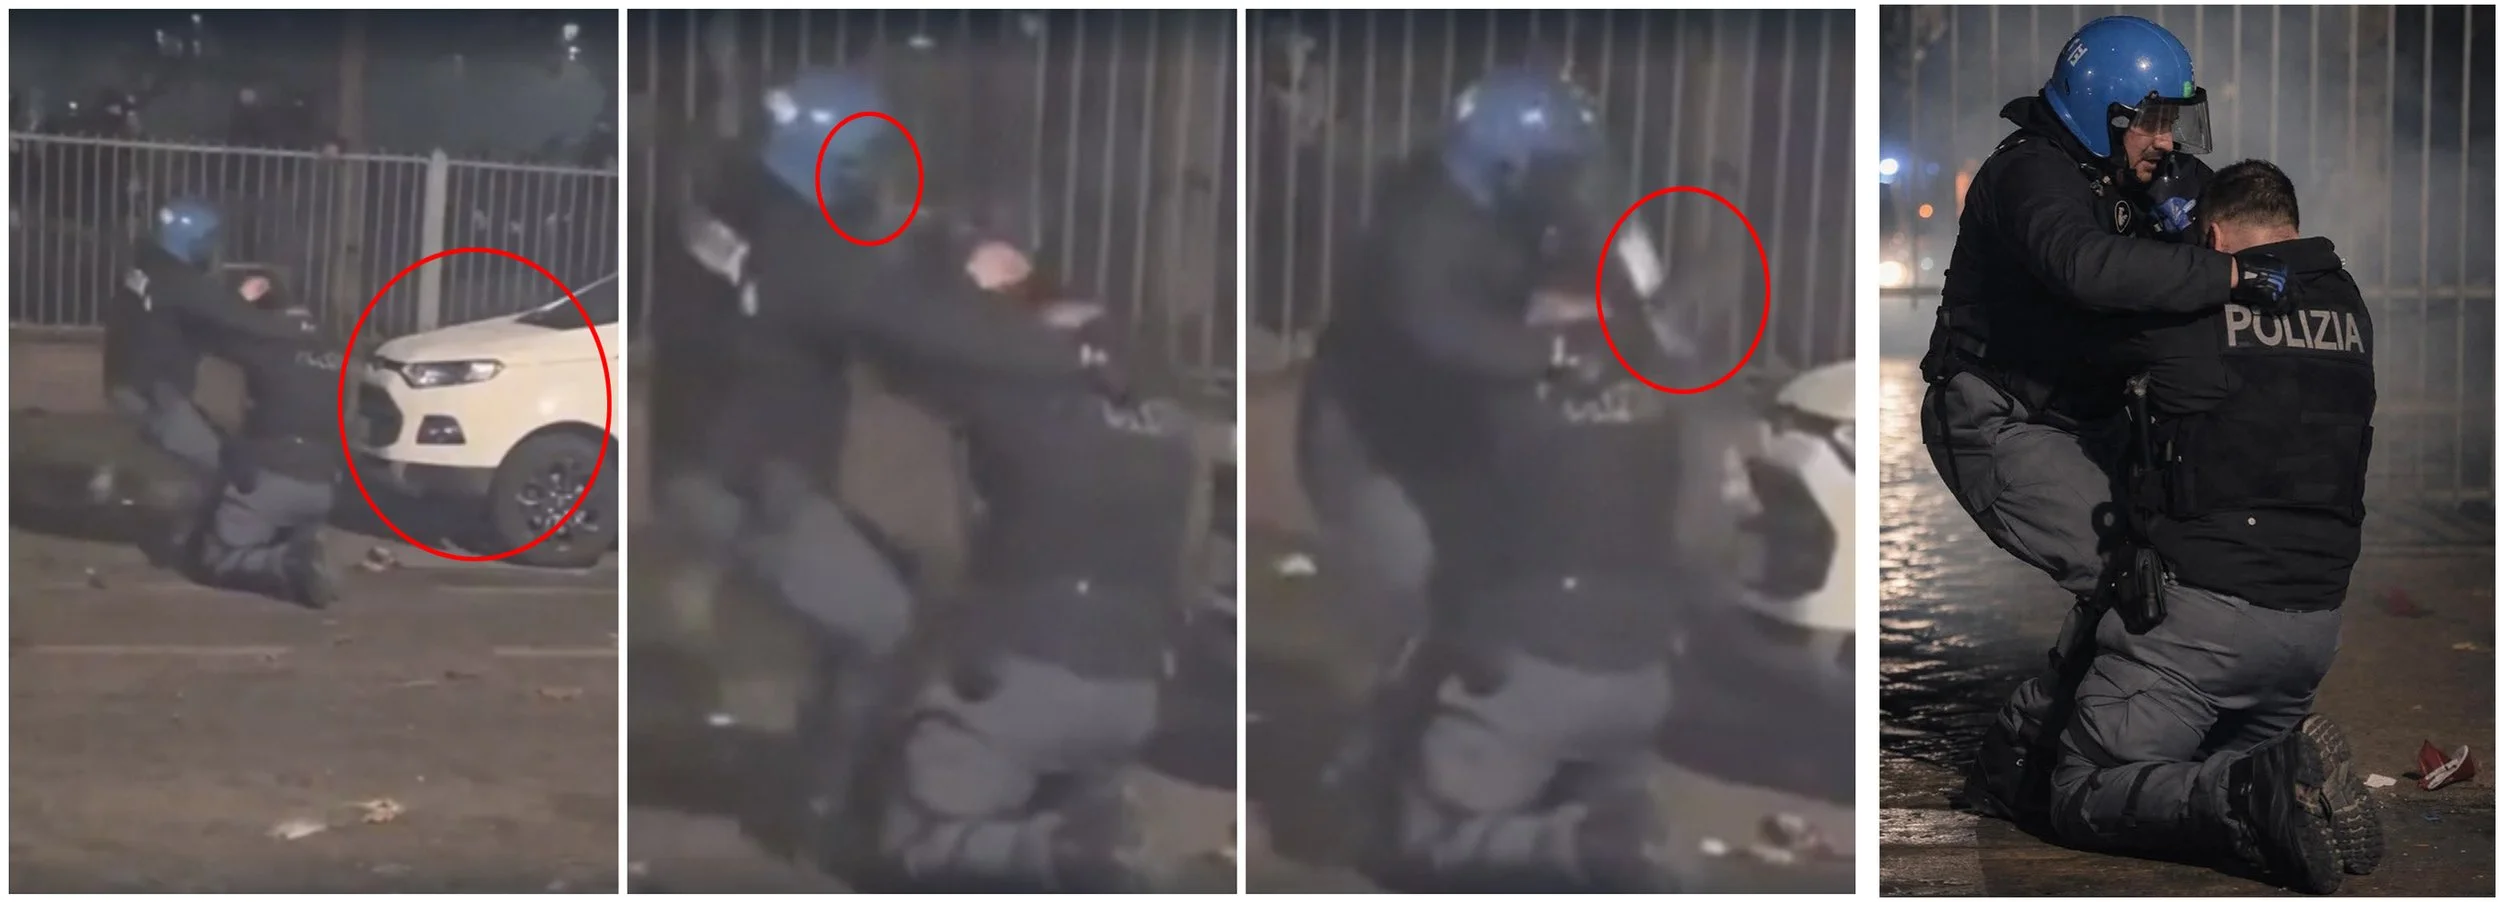
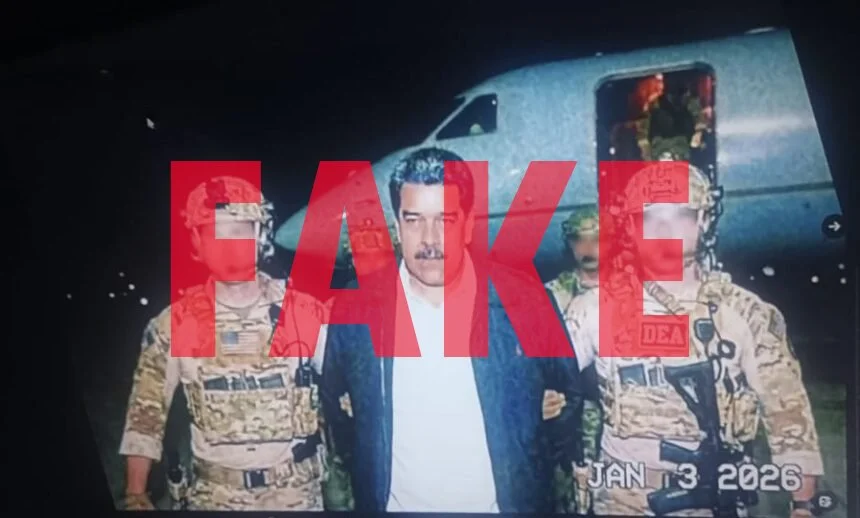
È quindi un tipo di immagine para-documentaria, che potremmo definire anche immagine fotografica apocrifa, che si sta imponendo, come visto nei mesi scorsi con l’intervento degli “eroi di Modena" o con il poliziotto aggredito a Torino e soccorso da un collega o ancora con l'arresto di Maduro (caso in cui l'immagine era però stata inventata completamente, senza partire da una documentazione video o di altro tipo), che racconta qualcosa di realmente avvenuto ma con un’estetica più pulita dei fotogrammi disponibili e che, in qualche modo, soddisfa maggiormente il fruitore grazie al suo essere immediatamente leggibile, al suo accentuare la componente emotiva e a essere visivamente più appagante, consentendole di diventare memorabile.

Modena, 16 maggio 2026. A sinistra, un fotogramma del video che documenta alcuni cittadini mentre immobilizzano Salim El Koudri dopo la fuga seguita all’investimento di alcuni pedoni nel centro della città. A destra, una ricostruzione della stessa scena generata con intelligenza artificiale, più nitida, ordinata e visivamente leggibile del materiale originale. Un evento realmente documentato viene così trasformato in un’immagine che sembra fotografica, ma non costituisce una testimonianza diretta di quel momento.

Torino, 31 gennaio 2026. A sinistra, alcuni fotogrammi del video che documenta il momento in cui l’agente di Polizia Lorenzo Virgulti raggiunge e protegge il collega Alessandro Calista, appena aggredito durante gli scontri avvenuti nel corso del corteo in sostegno di Askatasuna. A destra, la ricostruzione realizzata con intelligenza artificiale e successivamente diffusa anche dai canali istituzionali: la scena reale viene resa più nitida e drammatica, ma diversi elementi — dal volto dell’agente alla maschera antigas, allo scudo e allo sfondo — risultano modificati o ricostruiti.

L’aspetto forse più interessante è che l’efficacia di queste immagini può sopravvivere perfino alla scoperta della loro natura artificiale. Una volta accertato che il fatto è realmente avvenuto, lo spettatore può continuare a considerare quella rappresentazione sostanzialmente vera, anche sapendo che quel preciso istante non è mai esistito davanti a un obiettivo. La verità dell’evento finisce così per trasferire parte della propria credibilità a un’immagine che non ne costituisce una testimonianza.

Il meccanismo, naturalmente, non nasce con l’intelligenza artificiale. La fotografia e il giornalismo hanno sempre operato attraverso una selezione: tra molte immagini disponibili vengono privilegiate quelle capaci di sintetizzare meglio un evento, di renderlo immediatamente comprensibile e, spesso, di inserirsi in iconografie che il pubblico già conosce. La differenza decisiva è che, fino a poco tempo fa, bisognava trovare nella realtà l’immagine capace di incarnare quell’archetipo. Oggi è possibile produrla.

A questo si aggiunge la logica della circolazione sui social network. Un fotogramma autentico ma distante, confuso, mosso o poco spettacolare compete difficilmente con una sua ricostruzione nitida, drammatica e perfettamente leggibile. Paradossalmente, l’immagine autentica dell’evento può quindi essere sopraffatta da quella che lo rappresenta in maniera più efficace. Non perché quest’ultima racconti necessariamente un fatto diverso, ma perché elimina dalla realtà tutto ciò che è accidentale, ambiguo o visivamente poco convincente, trasformando l’evento in un’icona.

In sostanza, è un'illustrazione che si appropria dell’autorità testimoniale tradizionalmente attribuita alla fotografia.

Immagine generata con intelligenza artificiale e diffusa sui social il 3 gennaio 2026, per mostrare e confermare l’arresto di Nicolás Maduro da parte delle forze statunitensi. In questo caso l’immagine non ricostruisce un documento visivo di una scena realmente documentata, ma inventa il momento. L’autore della versione divenuta virale ha successivamente dichiarato di averla creata con l’IA e la presenza di una filigrana digitale SynthID ne ha confermato la natura sintetica.

Macchine che divorano libri /  by Filippo Venturi

Da mesi si parla del vizio delle principali aziende sviluppatrici di intelligenza artificiale (IA) di procurarsi milioni di libri con cui addestrare i propri modelli linguistici, per poi distruggerli una volta completata la procedura di digitalizzazione.

Nel 2024 Anthropic avviò il "Project Panama", un programma riservato che prevedeva l’acquisto di milioni di libri cartacei, la rimozione del dorso, la scansione ad alta velocità delle pagine e, infine, il riciclo di ciò che restava dei volumi. L’operazione aveva lo scopo di migliorare modelli come Claude. I libri erano infatti considerati una fonte di scrittura mediamente più strutturata e affidabile rispetto ai testi disponibili online, dove ormai proliferano anche contenuti generati dall’IA, spesso piatti, ripetitivi e inclini a riprodurre formule già esistenti.

L’addestramento delle IA sembra essere diventato una priorità tale da spingere le aziende a forzare continuamente i limiti dei diritti e delle regole esistenti. È accaduto con la privacy dei cittadini, i cui contenuti pubblicati sui social sono stati utilizzati senza un consenso realmente consapevole o un’adeguata trasparenza; con il diritto d’autore; con il ricorso ad archivi pirata e siti illegali; e ora persino con la distruzione materiale di milioni di libri.

La digitalizzazione industriale, infatti, richiedeva il taglio del dorso del volume, in modo da separarne le pagine e permettere agli scanner ad alta velocità di acquisirle automaticamente, come singoli fogli. Una volta terminata la scansione, ricomporre e rilegare ogni libro sarebbe stato troppo lento e costoso. Per questo, ciò che ne rimaneva veniva riciclato.

La distruzione era quindi la conseguenza del metodo più rapido ed economico scelto per trasformare milioni di libri in dati. A suo modo, un’immagine simbolica del nostro tempo, in cui le macchine divorano i libri, ne digeriscono il contenuto e ne defecano i resti.

(Questa è una fotografia di un magazzino di libri di Anthropic, archiviata fra gli atti giudiziari e ottenuta dal Washington Post)

L'Odissea di Nolan e l'intelligenza artificiale /  by Filippo Venturi

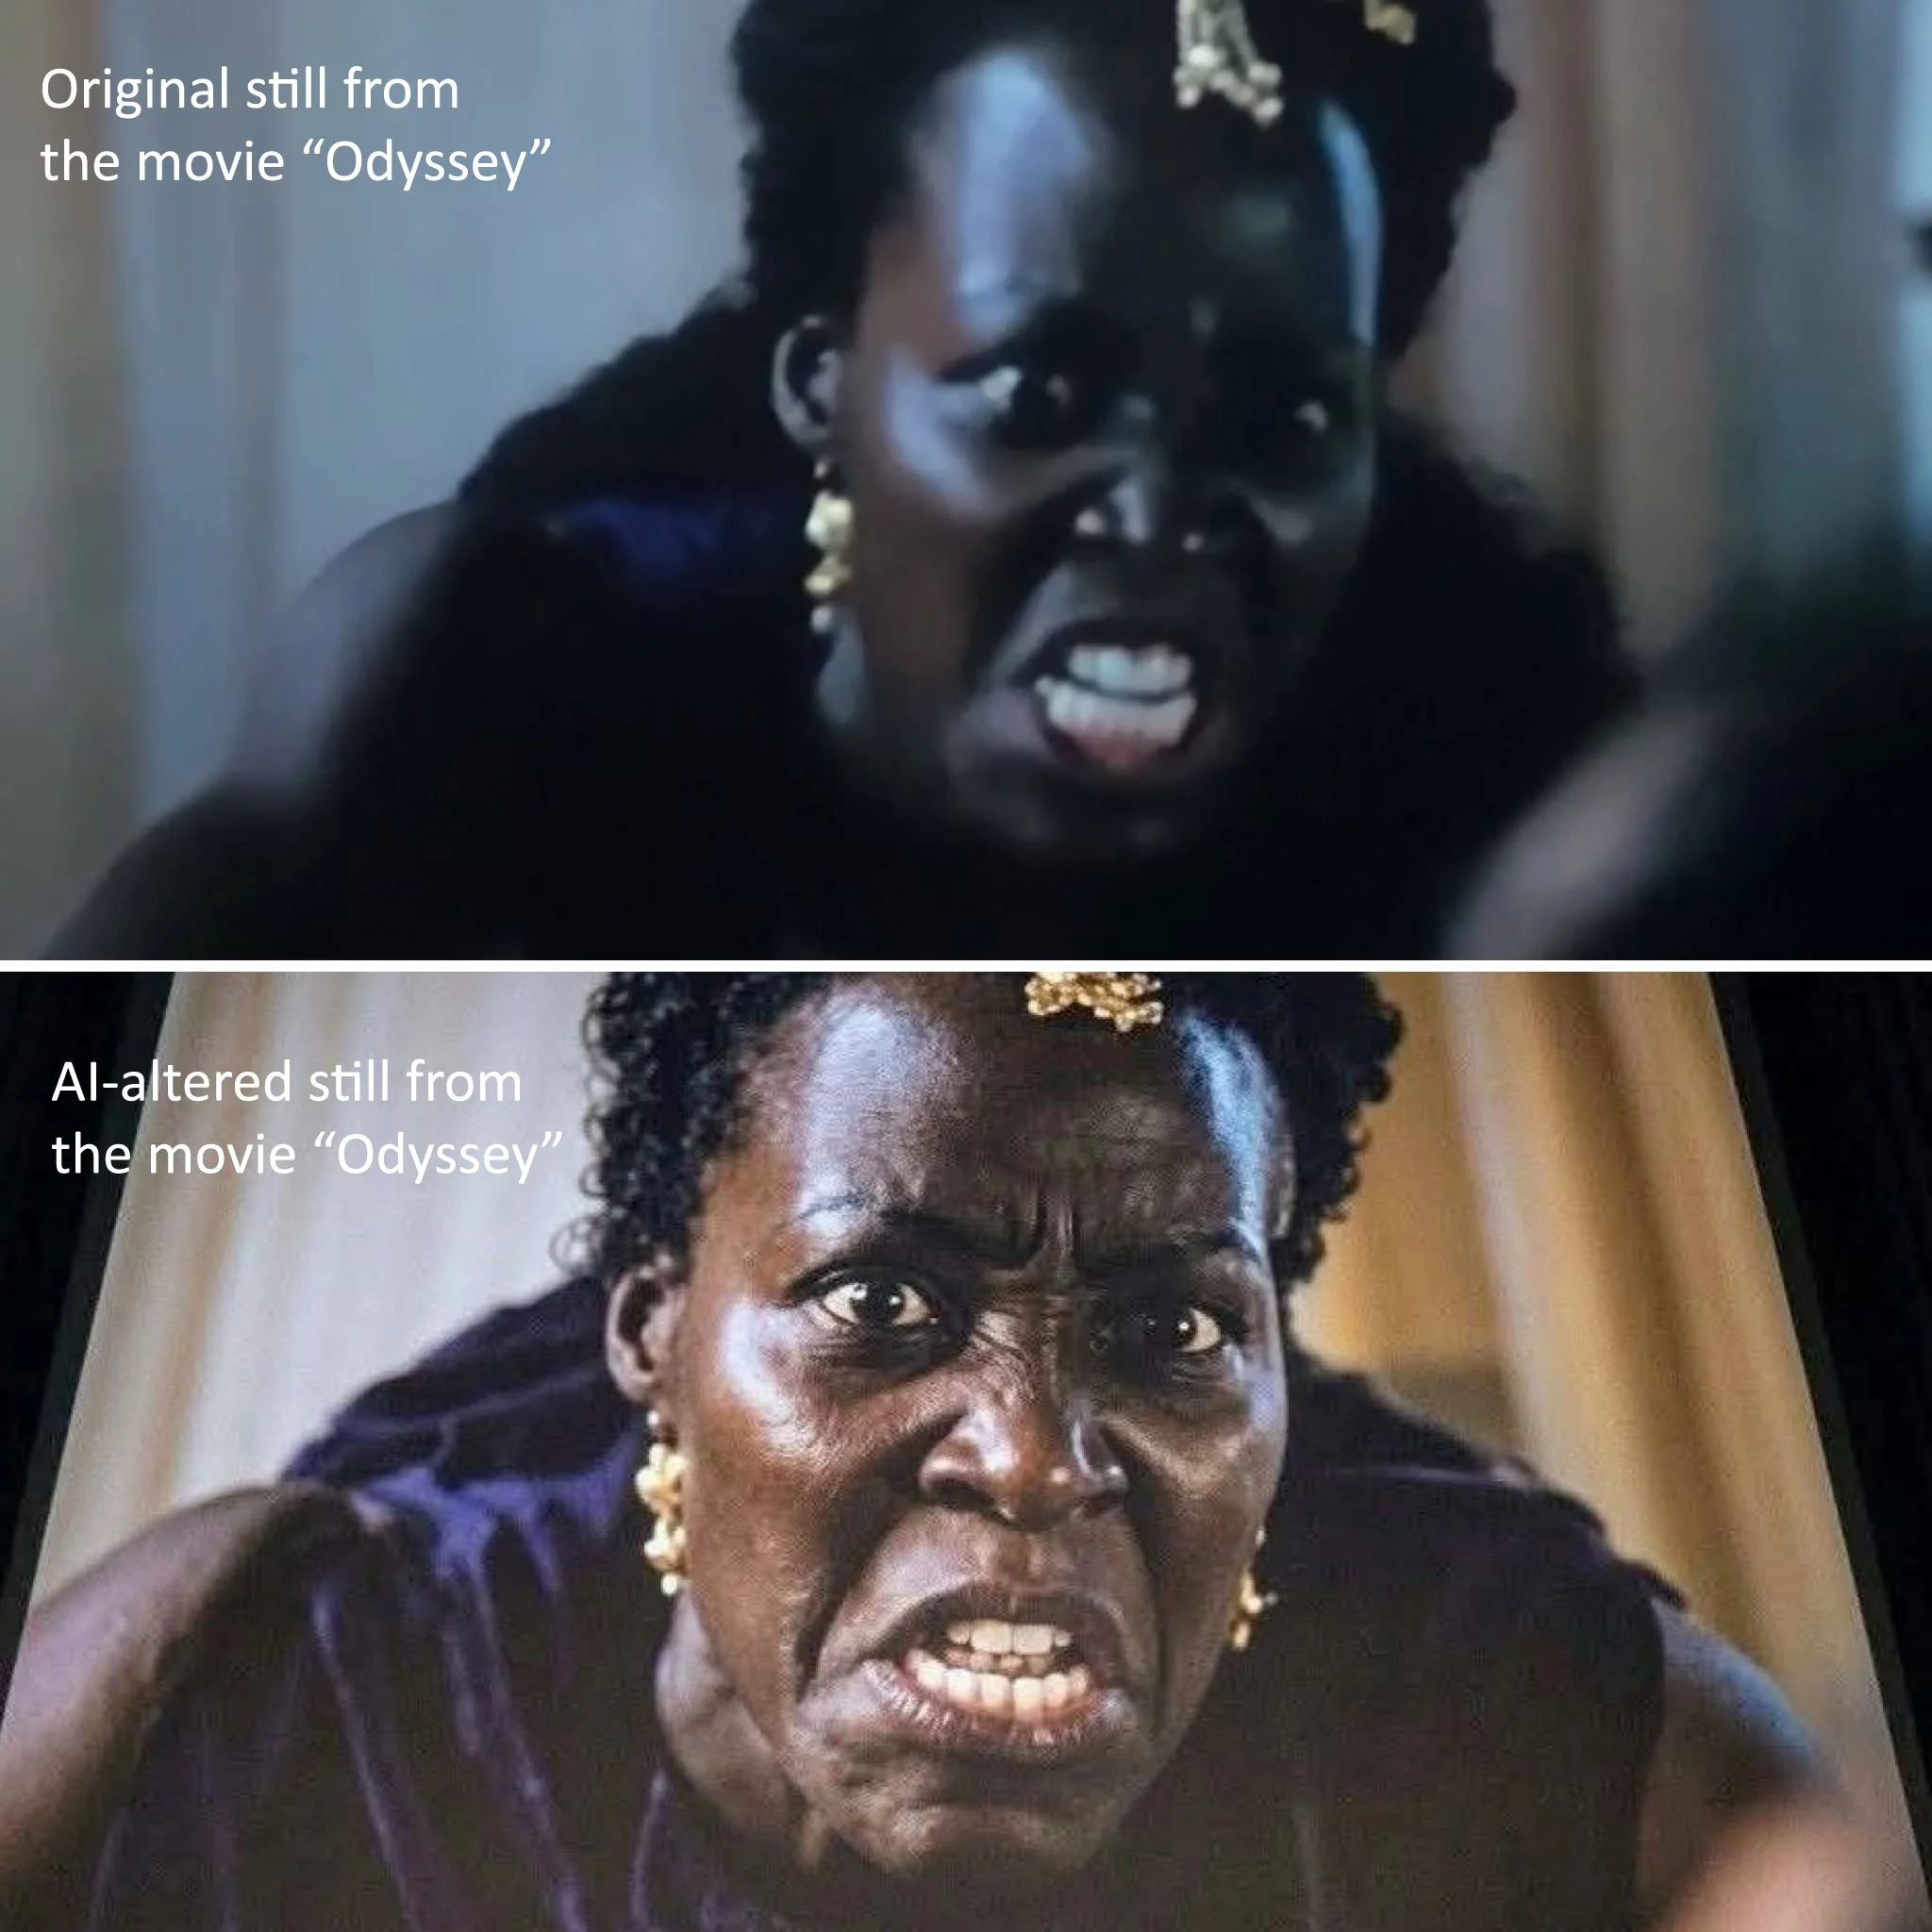
Probabilmente avrete letto delle polemiche sulla scelta di Lupita Nyong’o per interpretare Elena di Troia nel film "Odissea" di Christopher Nolan.

Al di là del fatto che qualunque attrice chiamata a incarnare "la donna più bella del mondo" sarebbe inevitabilmente finita sotto esame, in questo caso la causa principale delle contestazioni è stata il colore della sua pelle.

Qualcuno ha pensato bene di modificare con l’intelligenza artificiale un fotogramma del film (dove il viso è già deformato perchè sta gridando), alterando il volto dell’attrice per renderlo meno attraente e gettando benzina sul fuoco di una discussione animata da odiatori e attraversata da razzismo e disinformazione. Sui social l'immagine modificata sta girando parecchio.

Non è la prima volta e certamente non sarà l’ultima. Questo però rappresenta un ulteriore episodio che conferma il timore che l'IA, in ambito visivo, continui ad affermarsi come strumento per la manipolazione della realtà con finalità propagandistiche o divisive.

E la facilità di utilizzo rende alla portata di chiunque alterazioni che in passato richiedevano più competenze. Quindi, sì, potevano farlo prima con Photoshop o simili, ma ora può farlo chiunque con una semplice istruzione testuale o verbale (prompt).

Anche contenuti apparentemente innocui, come i meme, nei quali immagini e video generati con l’IA sono ormai sempre più diffusi, possono contribuire a questo processo di normalizzazione delle immagini false, rafforzando pregiudizi e rendendo sempre più incerto il confine tra ciò che è vero e ciò che è manipolato.

Faceless Generation - Un progetto sul riconoscimento facciale /  by Filippo Venturi

[english below]

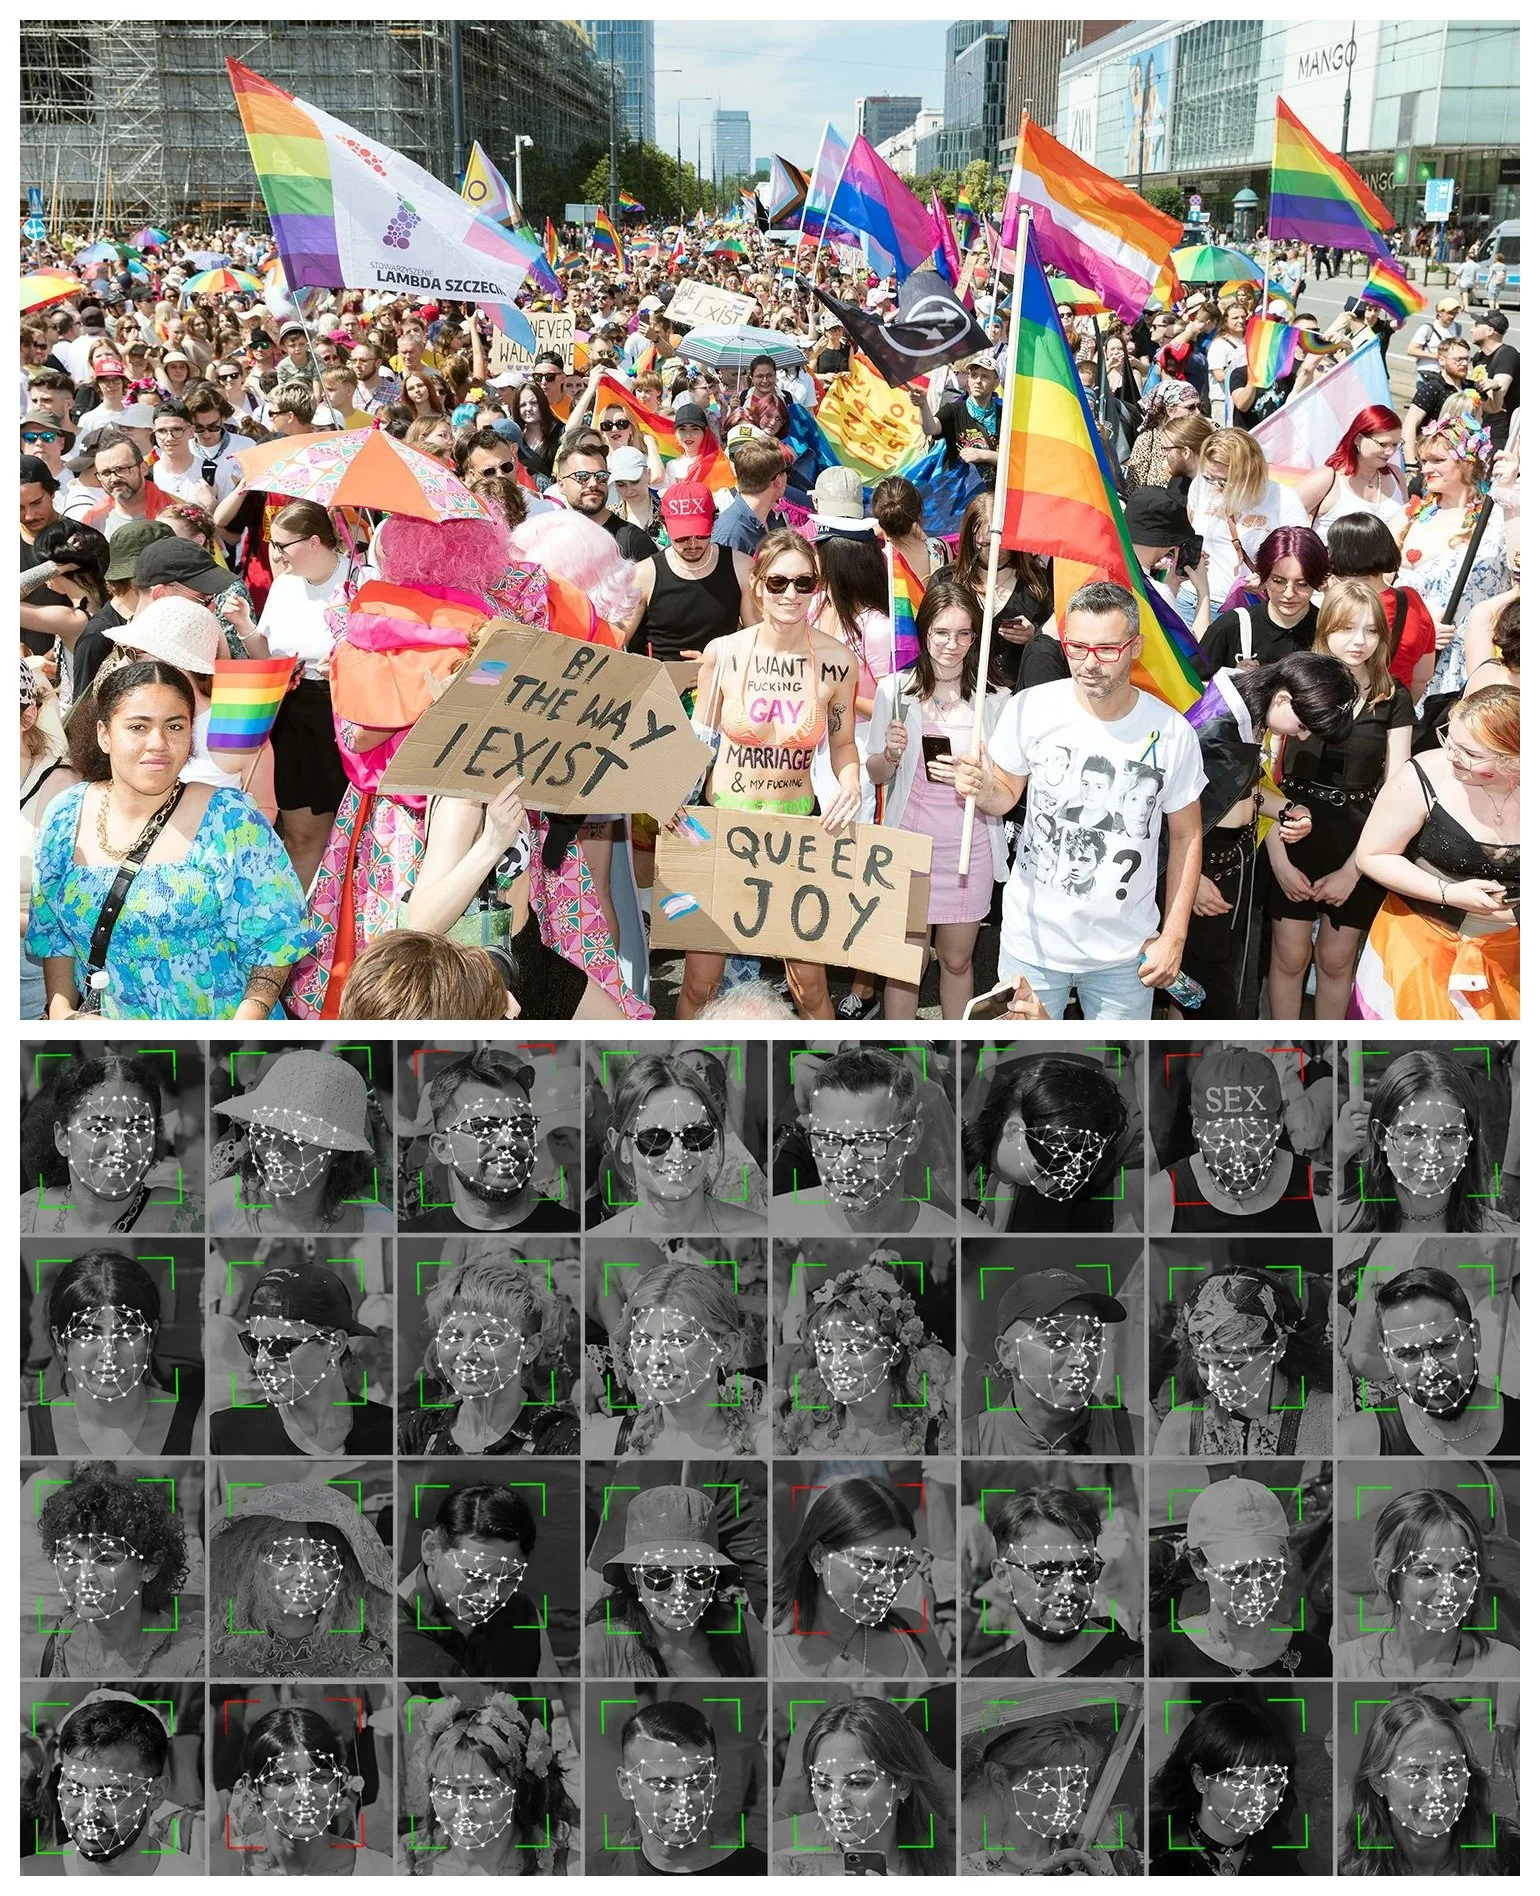
Faceless Generation è una ricerca visiva e documentaria che interroga il rapporto tra identità, visibilità e sorveglianza tecnologica.

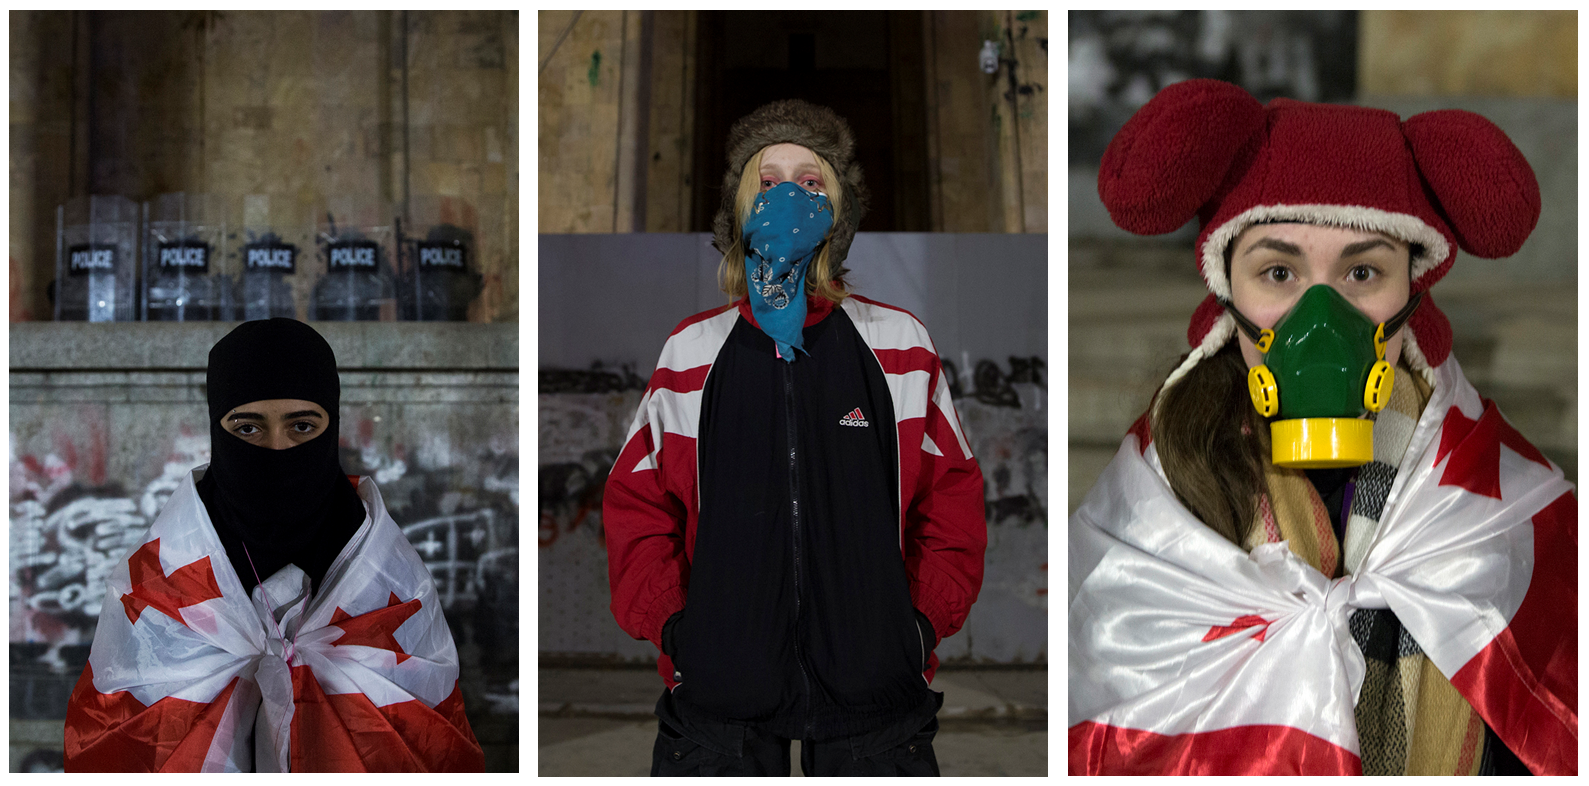
Il progetto nasce dalla mia esperienza di fotografo documentarista in Georgia, durante le proteste del 2024, nel corso delle quali ho osservato come la sorveglianza biometrica, attraverso il riconoscimento facciale, potesse essere impiegata su larga scala per identificare, rintracciare e colpire i manifestanti.

Questa tecnologia è ormai presente in aeroporti, frontiere, infrastrutture urbane, dispositivi personali e apparati di sicurezza. Promette sicurezza, efficienza e semplificazione dell’accesso, ma introduce una forma di controllo spesso invisibile, capace di trasformare la presenza nello spazio pubblico in una traccia permanente. Quando viene impiegato per sorvegliare le proteste, questo processo coinvolge direttamente la libertà di espressione, il diritto di manifestare e la possibilità di esprimere il dissenso senza essere automaticamente identificati.

Cosa accade quando il volto smette di essere soltanto il luogo dell’identità e diventa un dato da acquisire e classificare, a disposizione delle stesse autorità che il dissenso mette in discussione? A partire dall’esperienza georgiana, ho ideato e sviluppato delle strategie di occultamento e distorsione attraverso le quali l’immagine del volto tenta di sottrarsi, confondersi o generare un errore nello sguardo algoritmico.

Il progetto si articola in tre tipologie di immagini:

  1. Reportage. Una selezione di mie fotografie delle proteste georgiane, da cui nasce l’idea di questo progetto, e di altre manifestazioni che ho documentato in altri paesi.

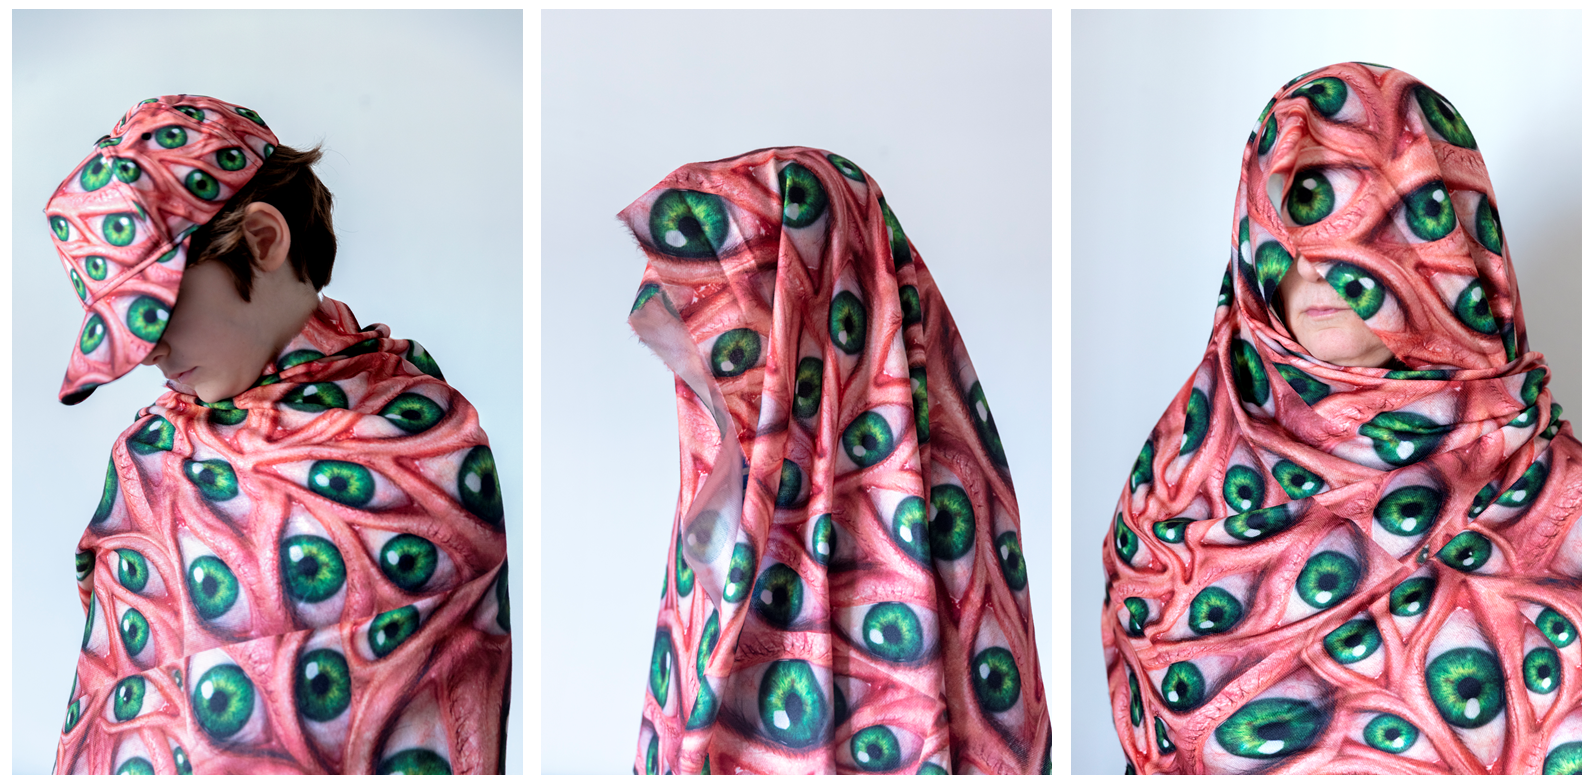
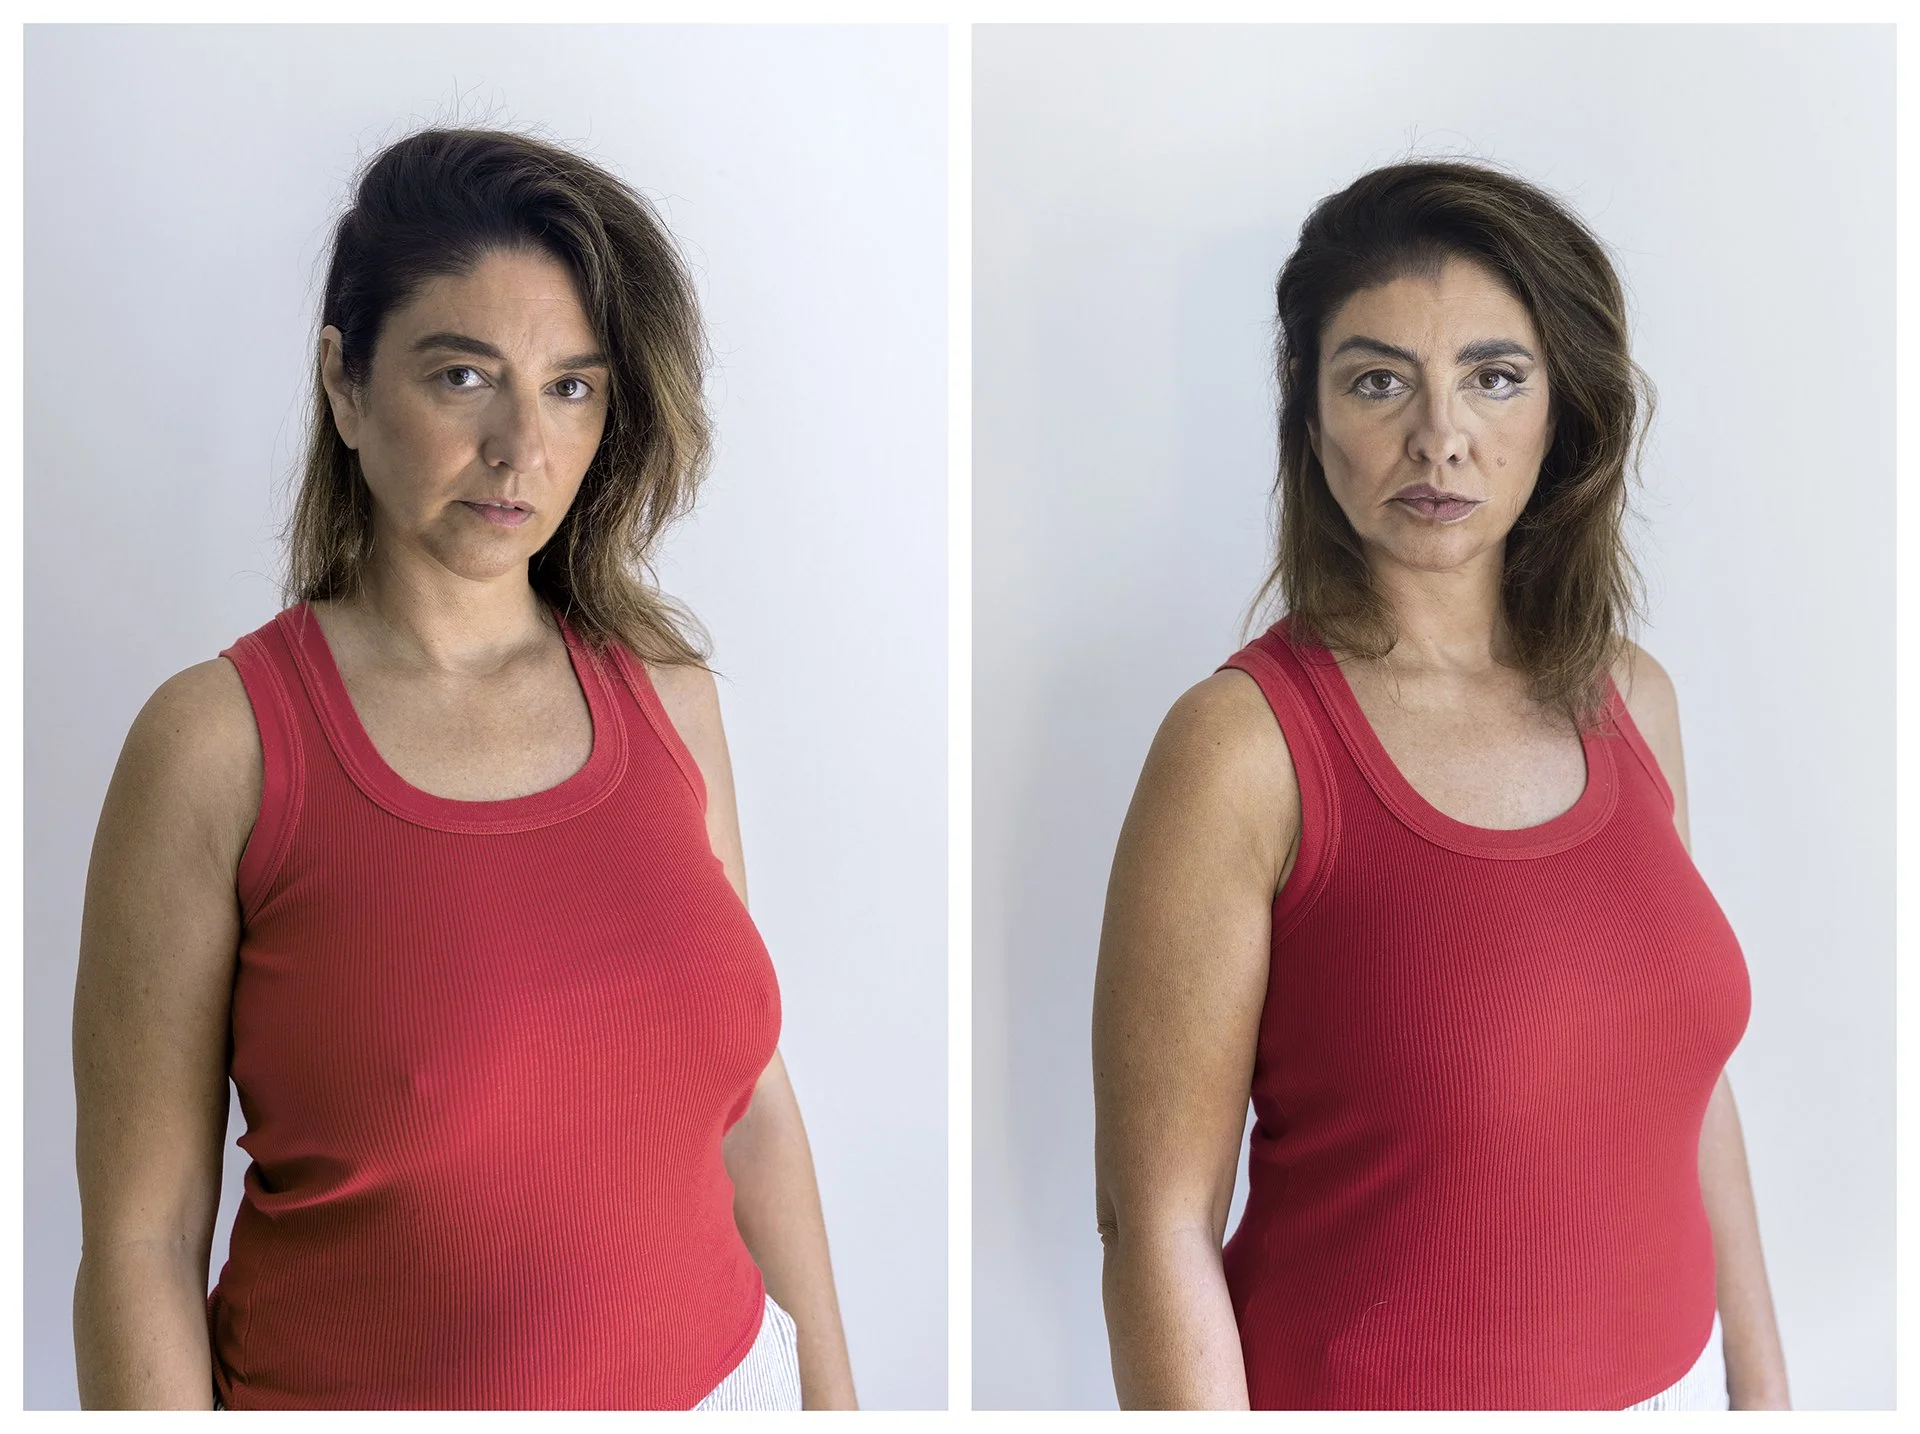
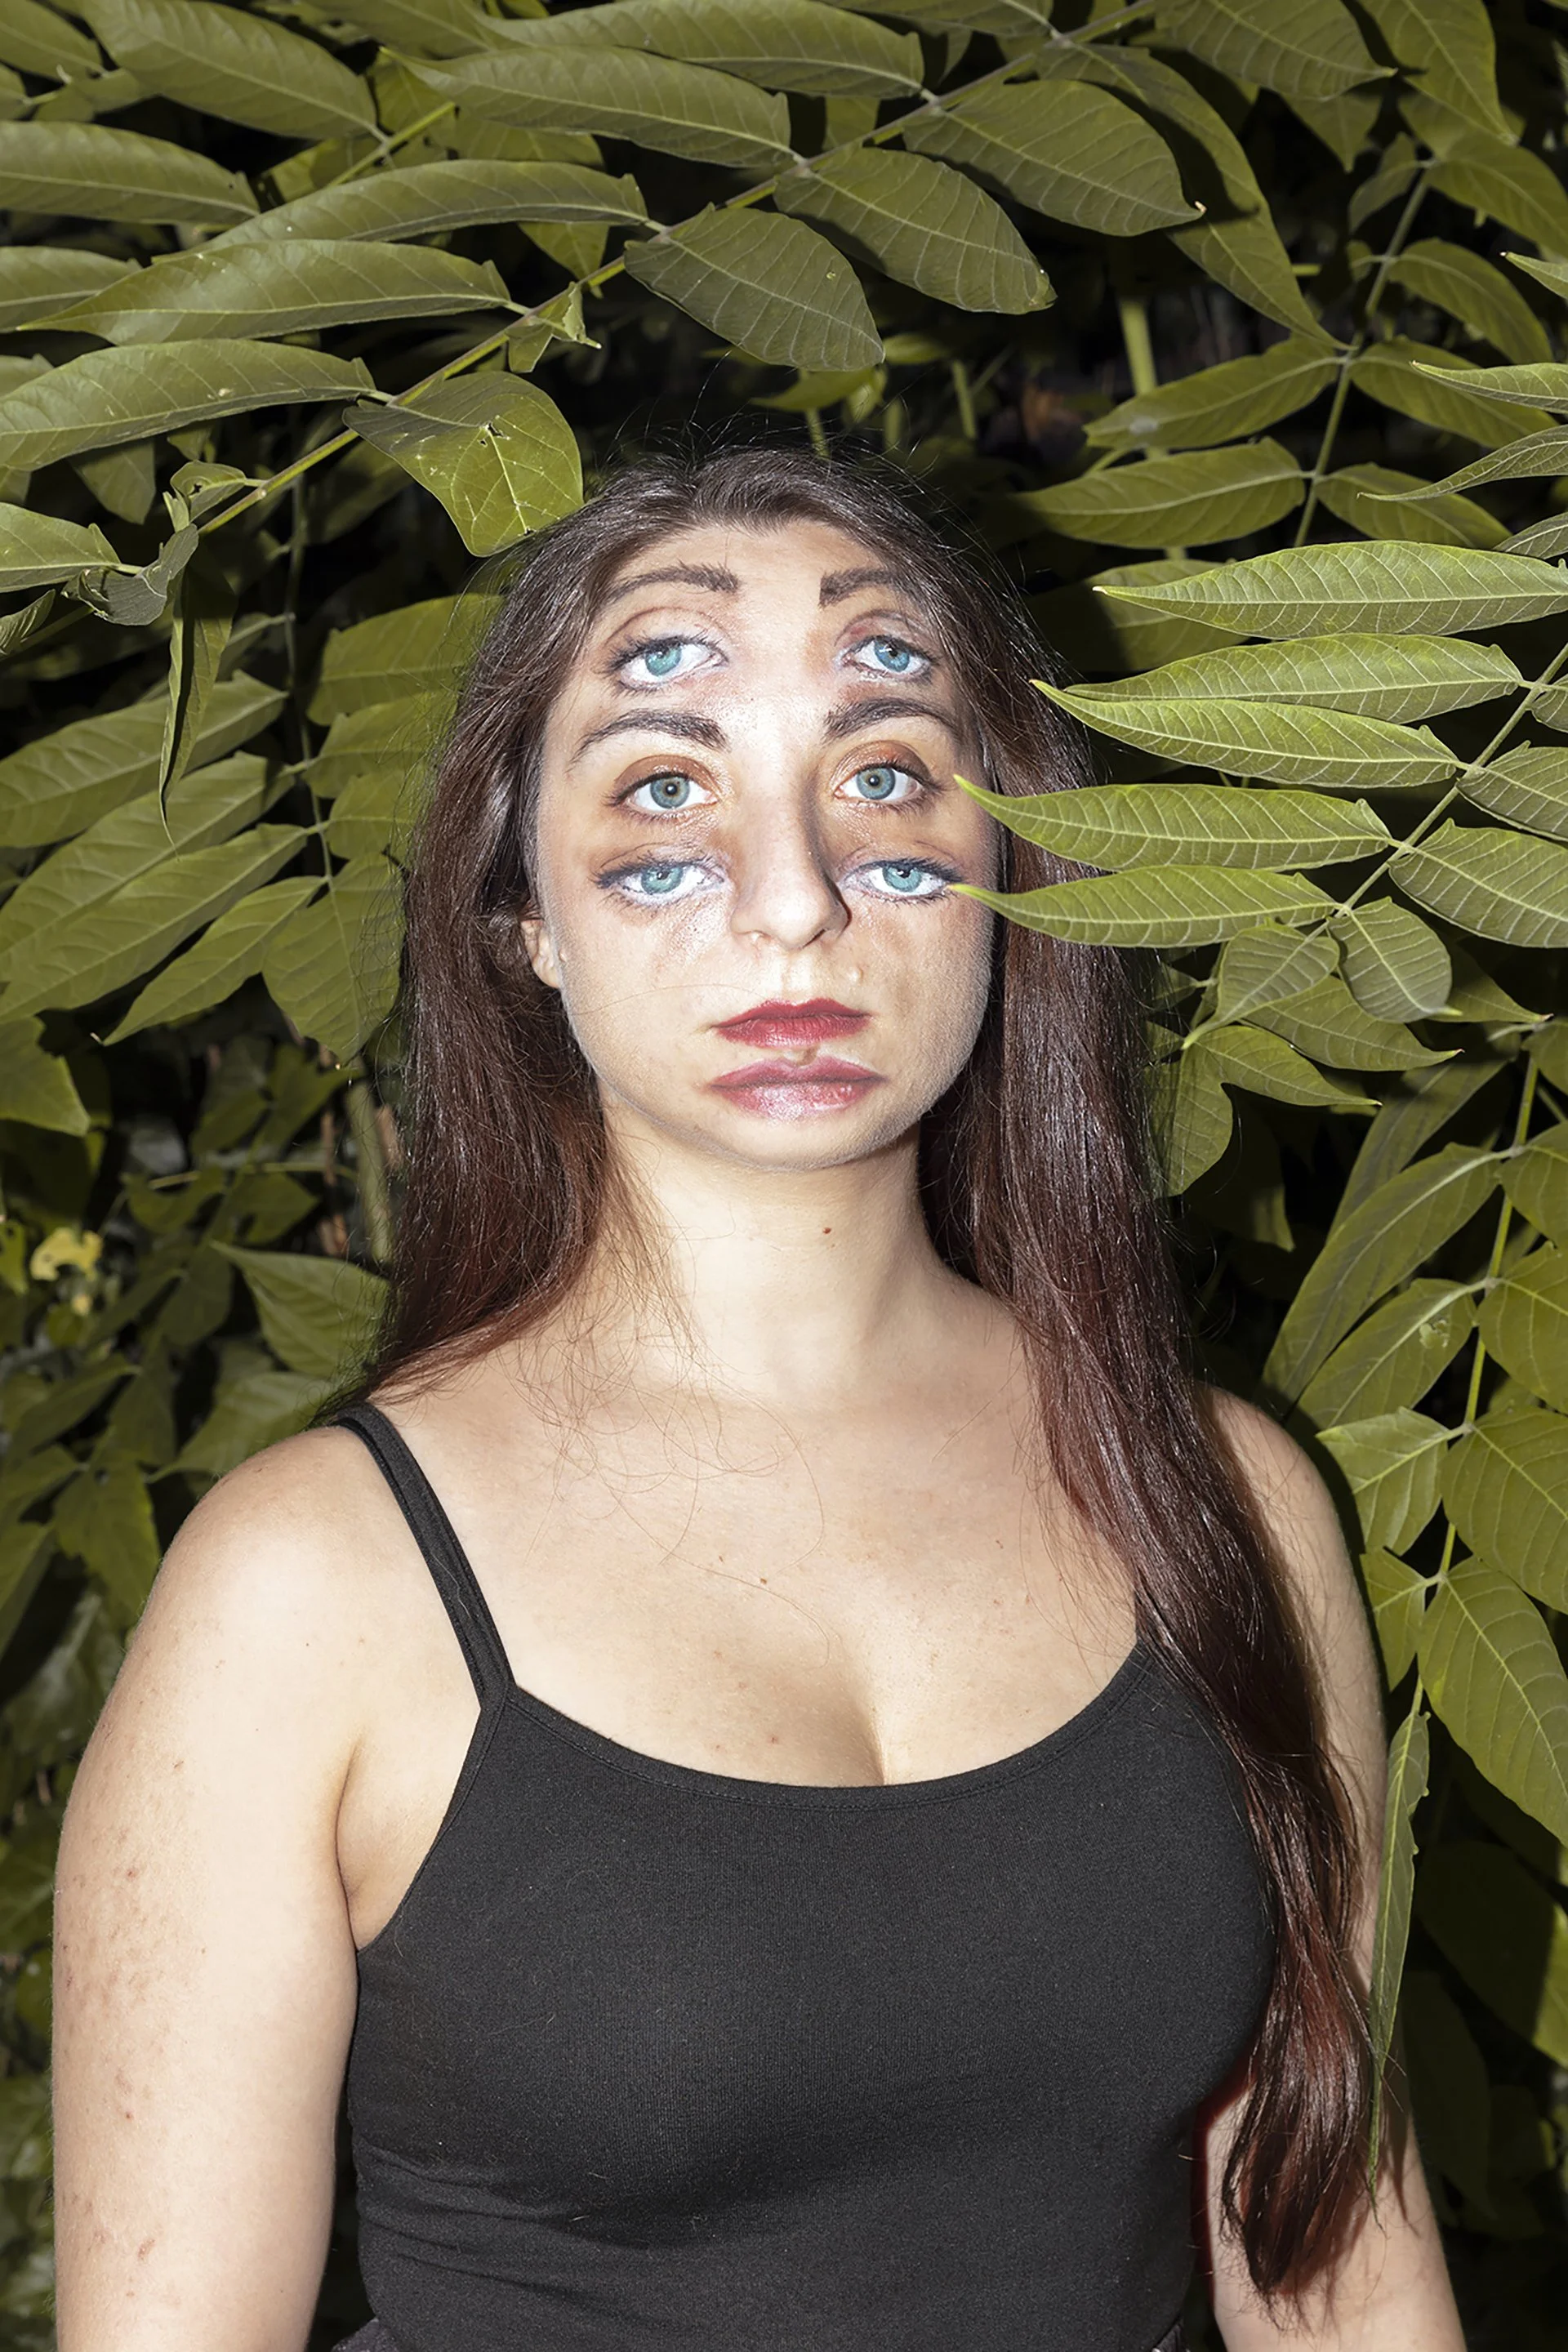
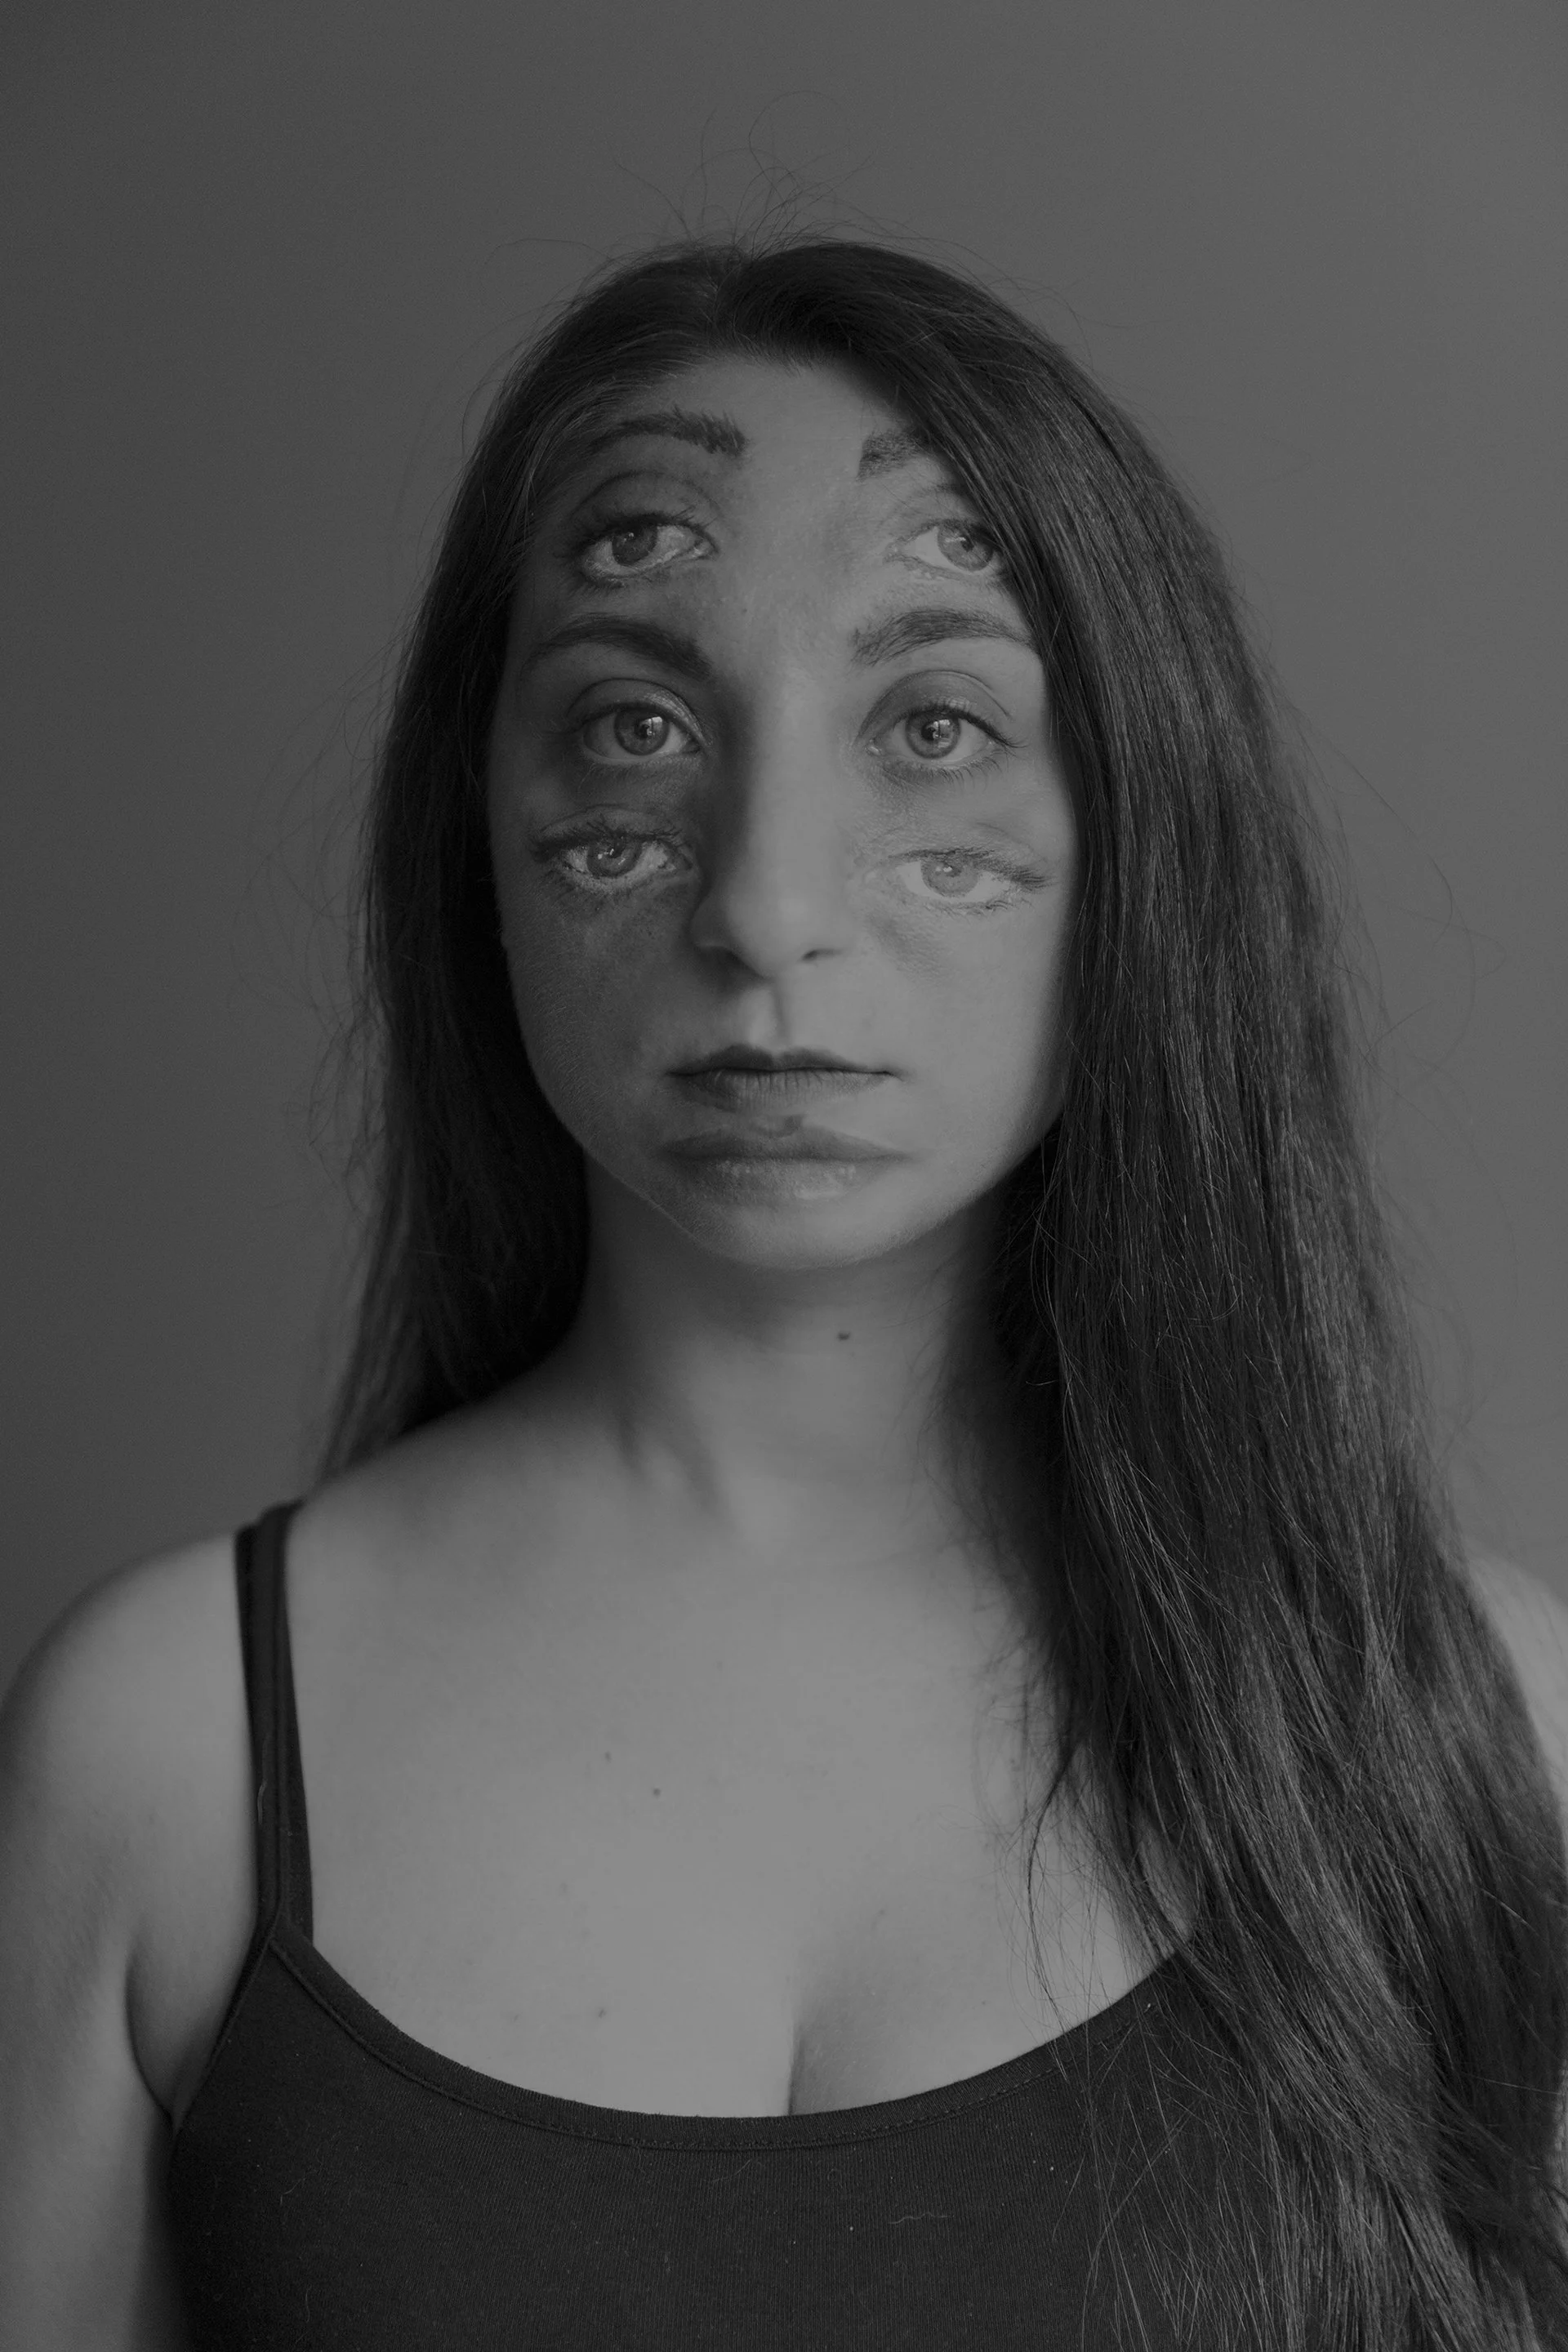
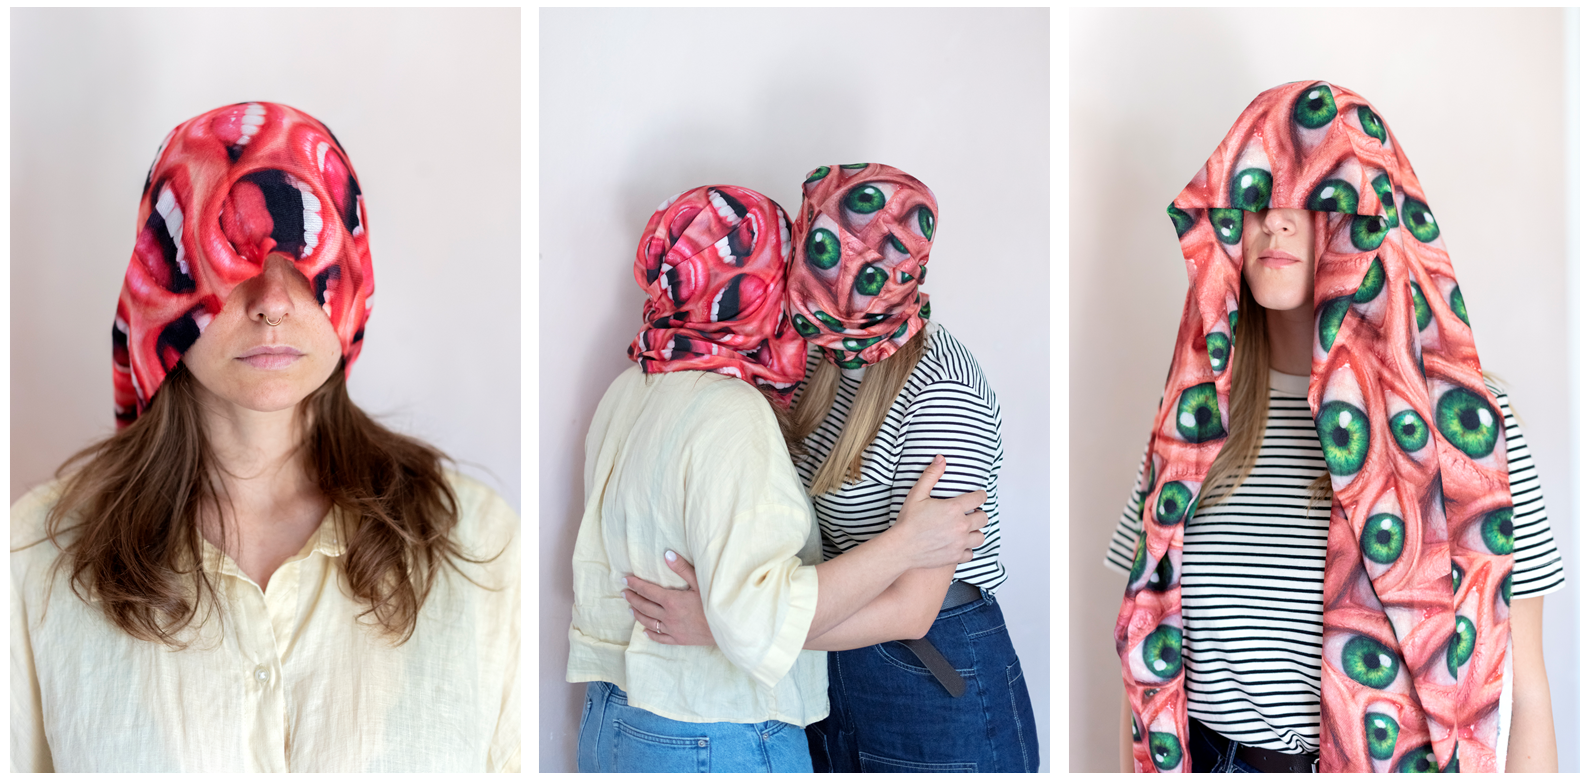
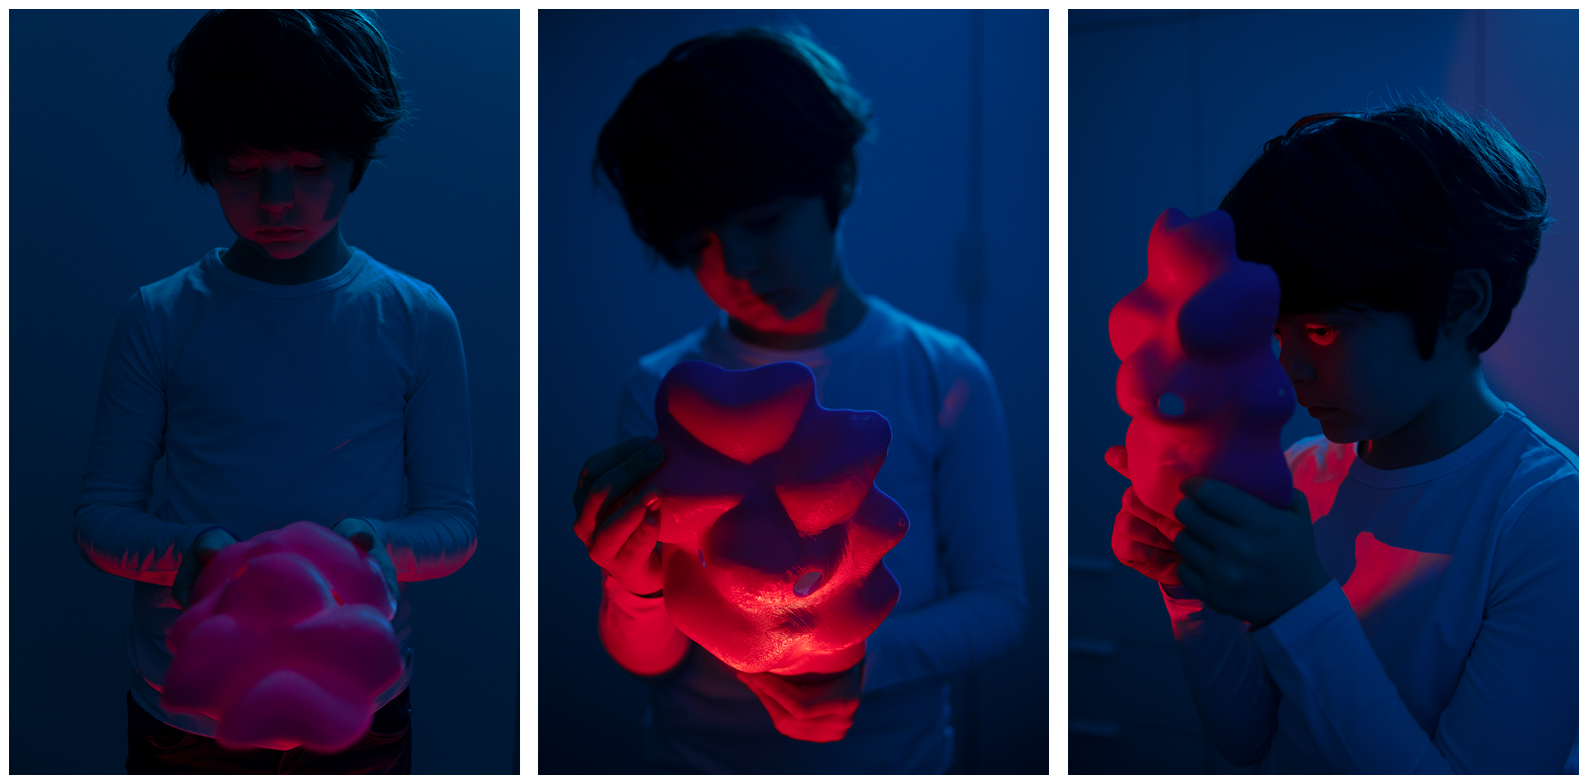
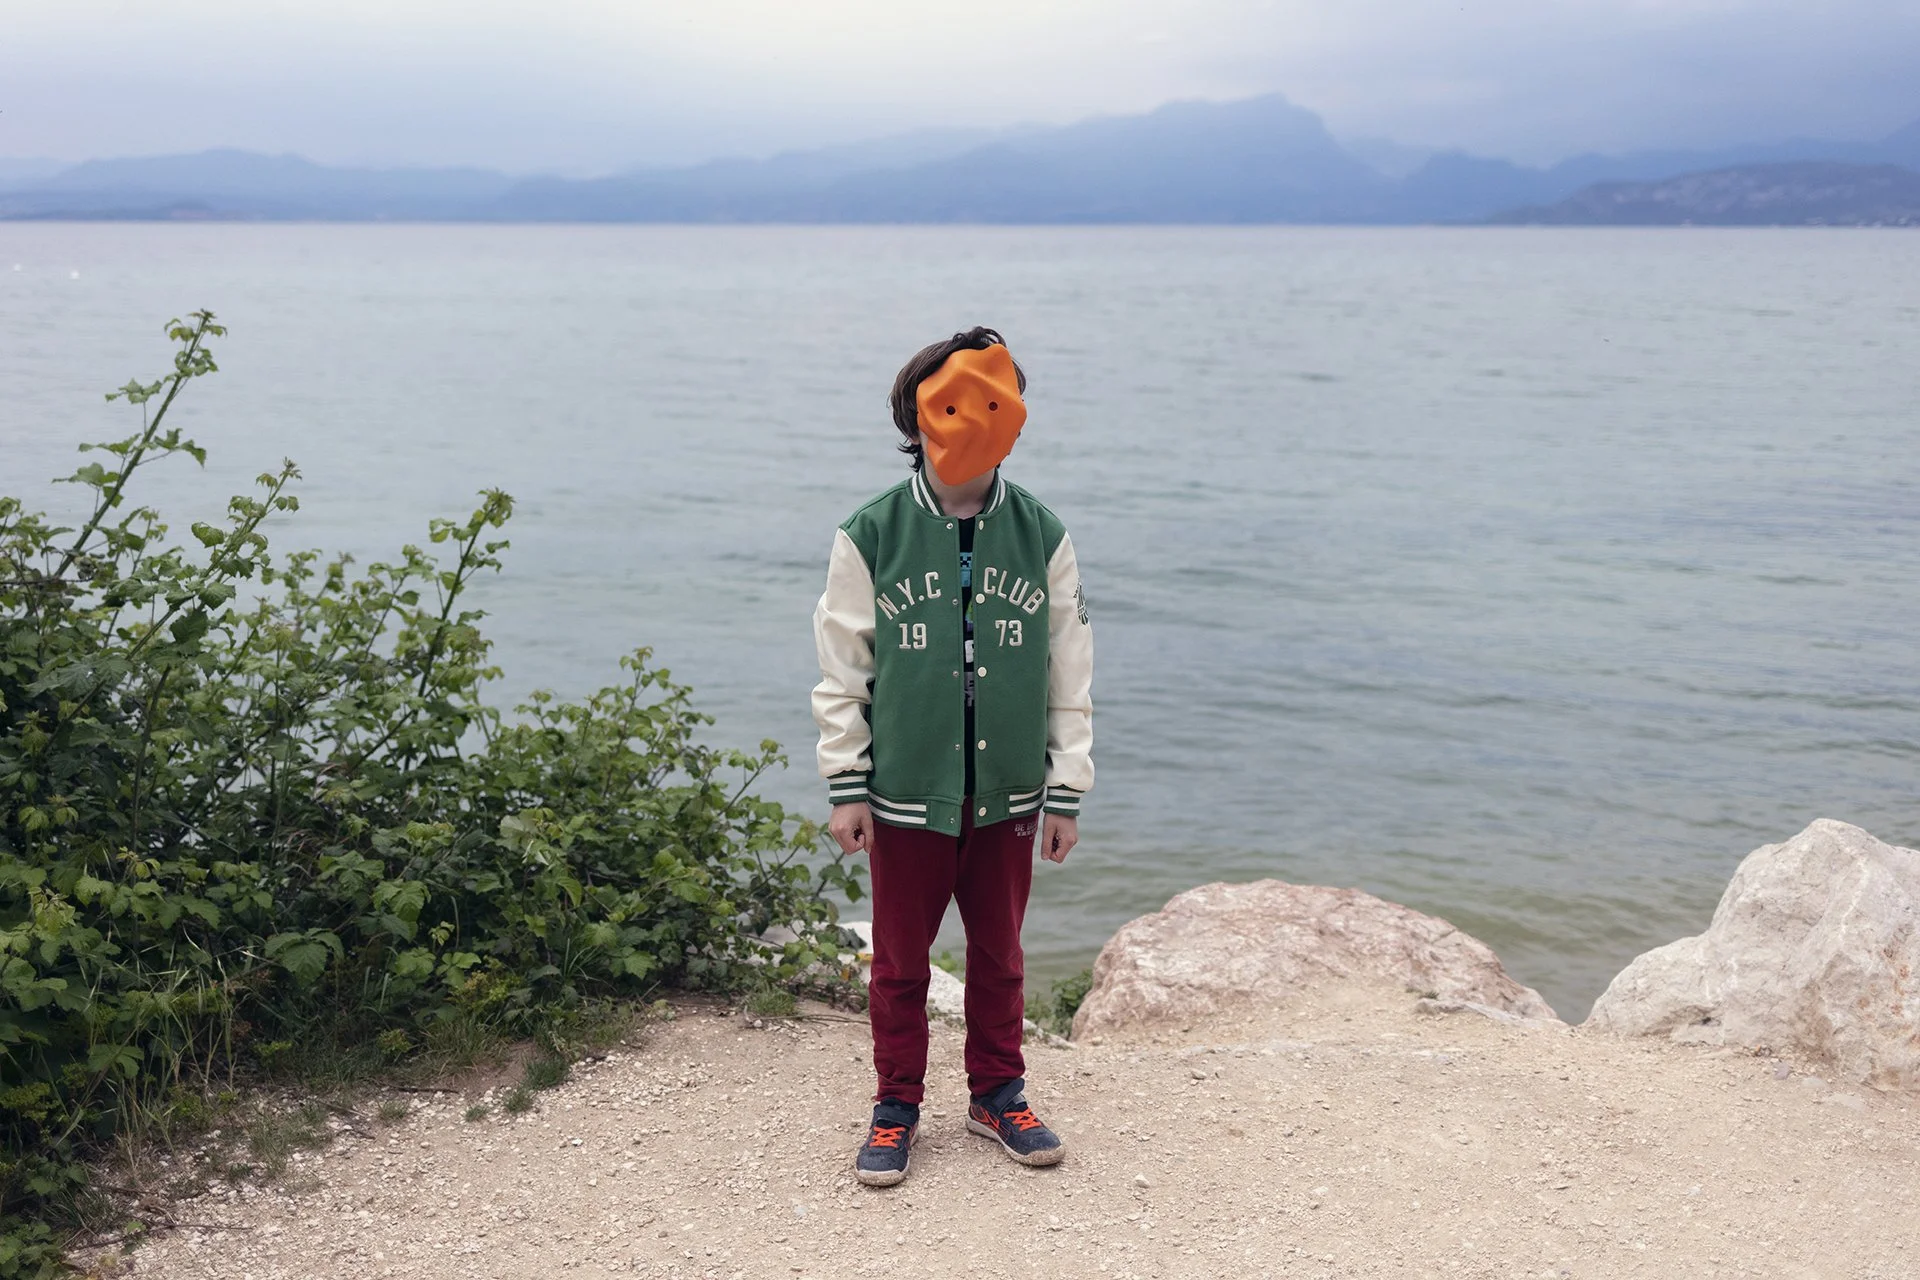
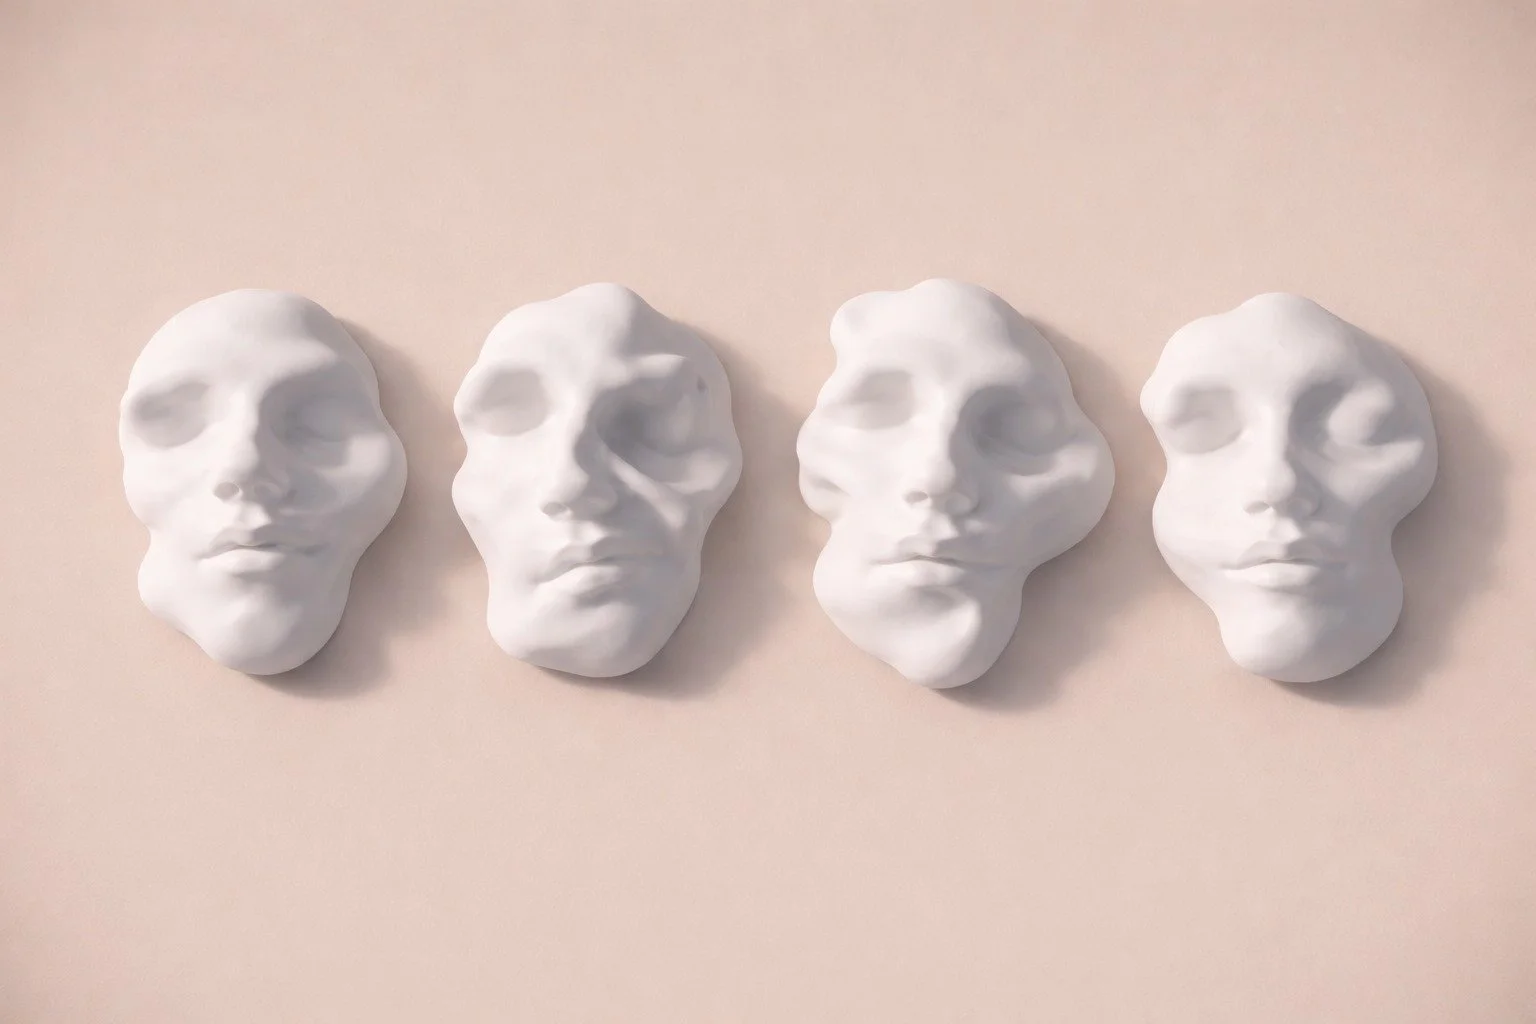
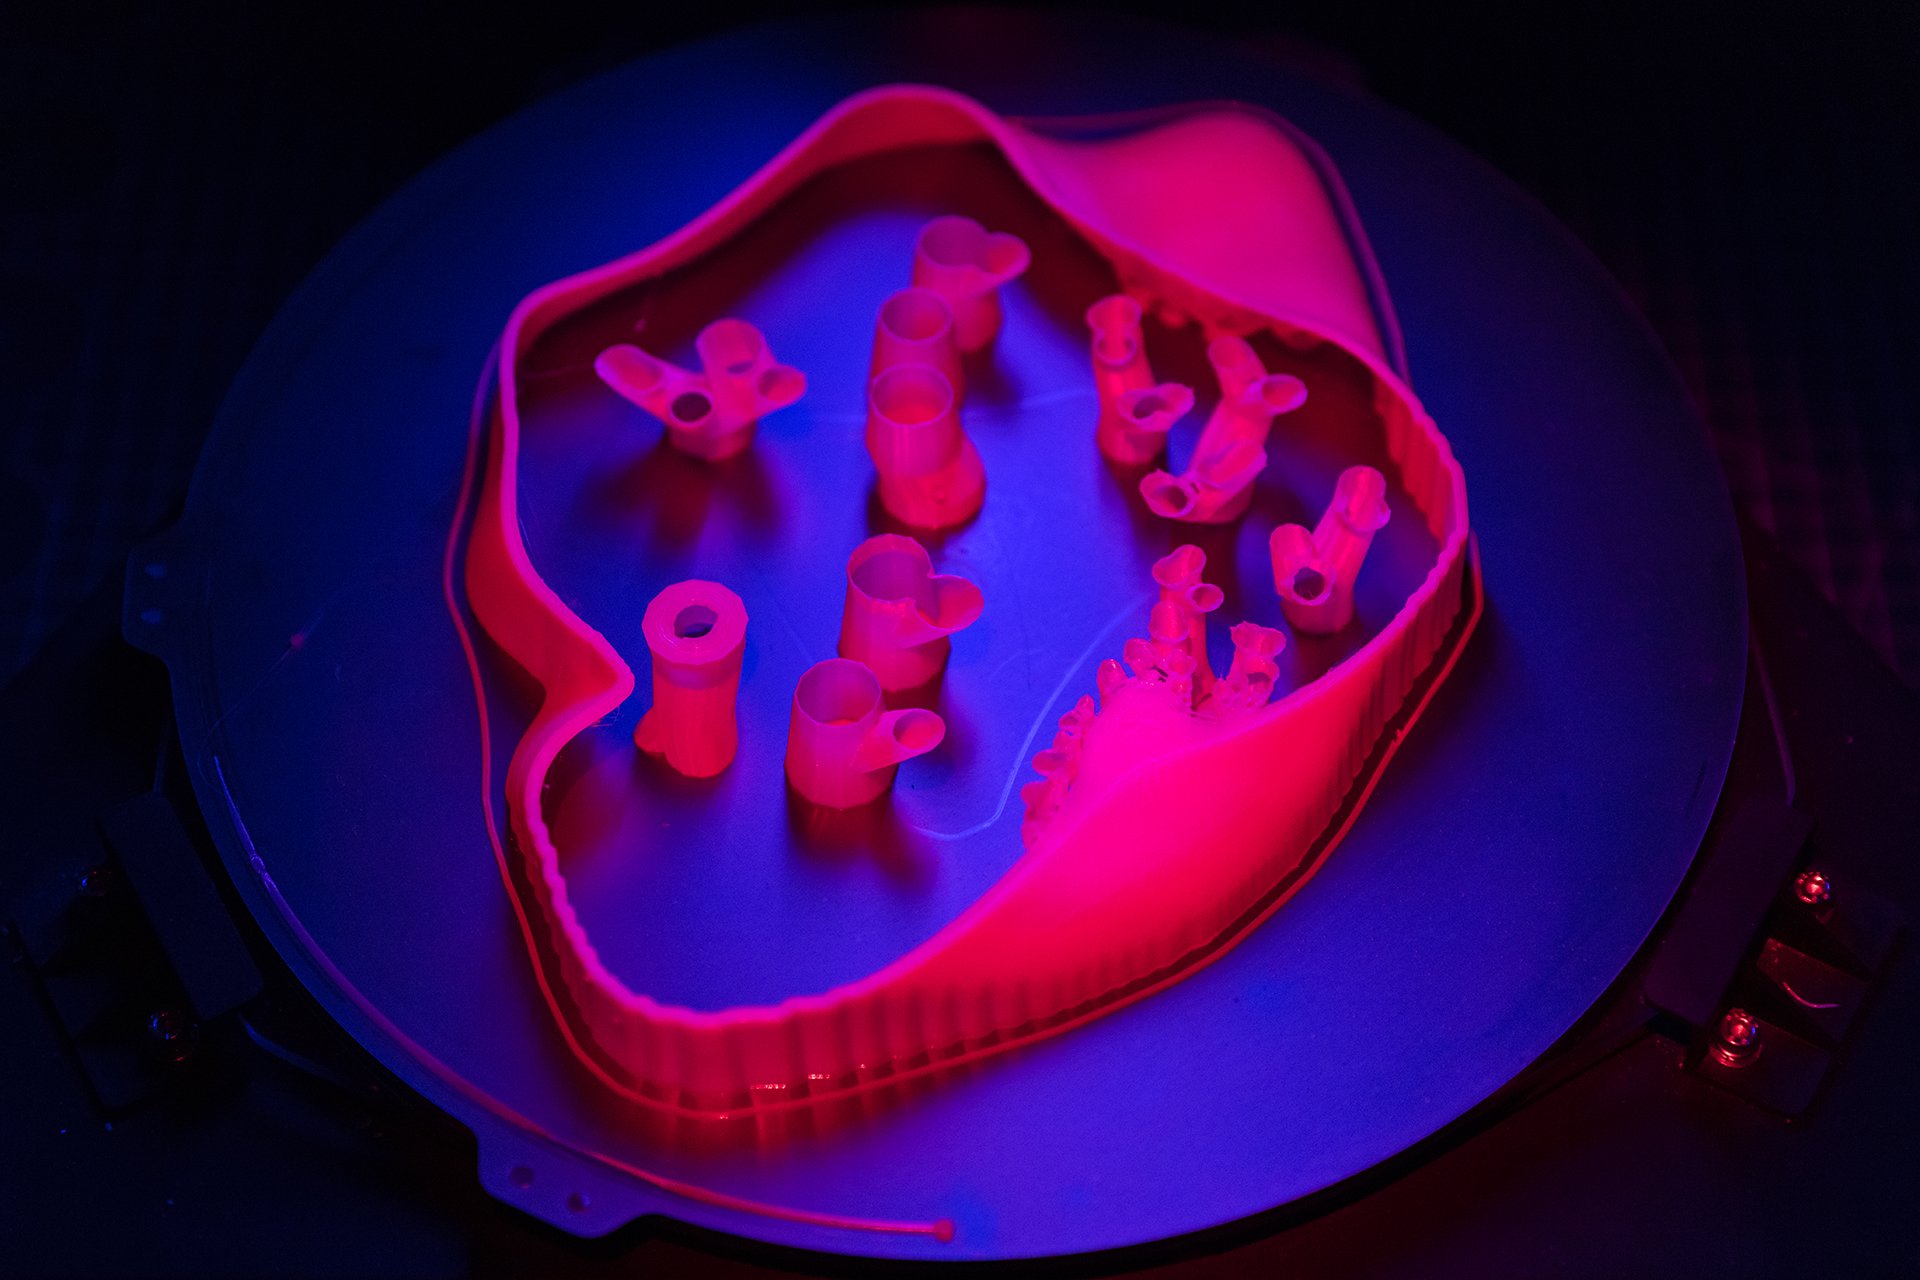
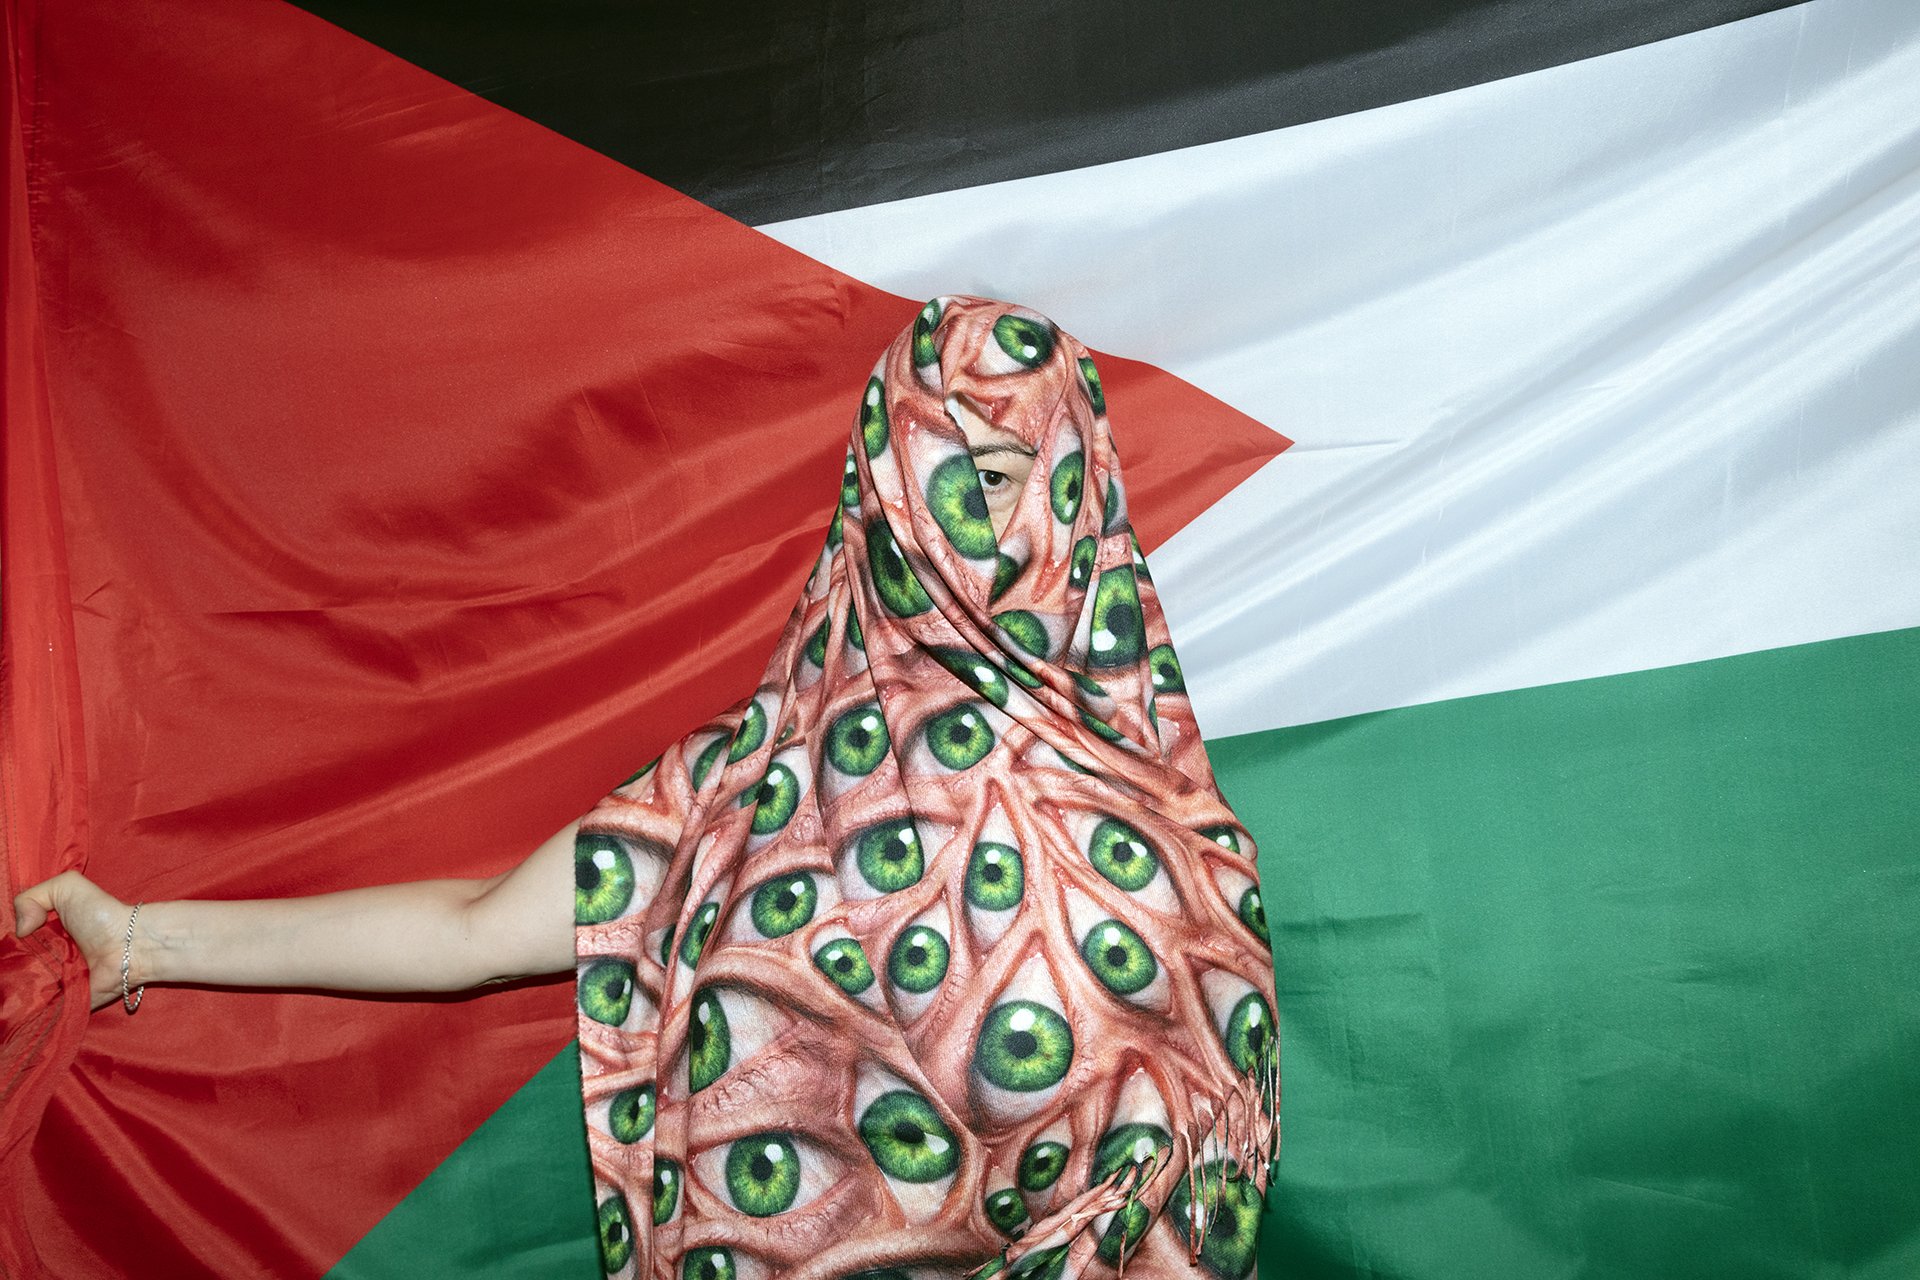
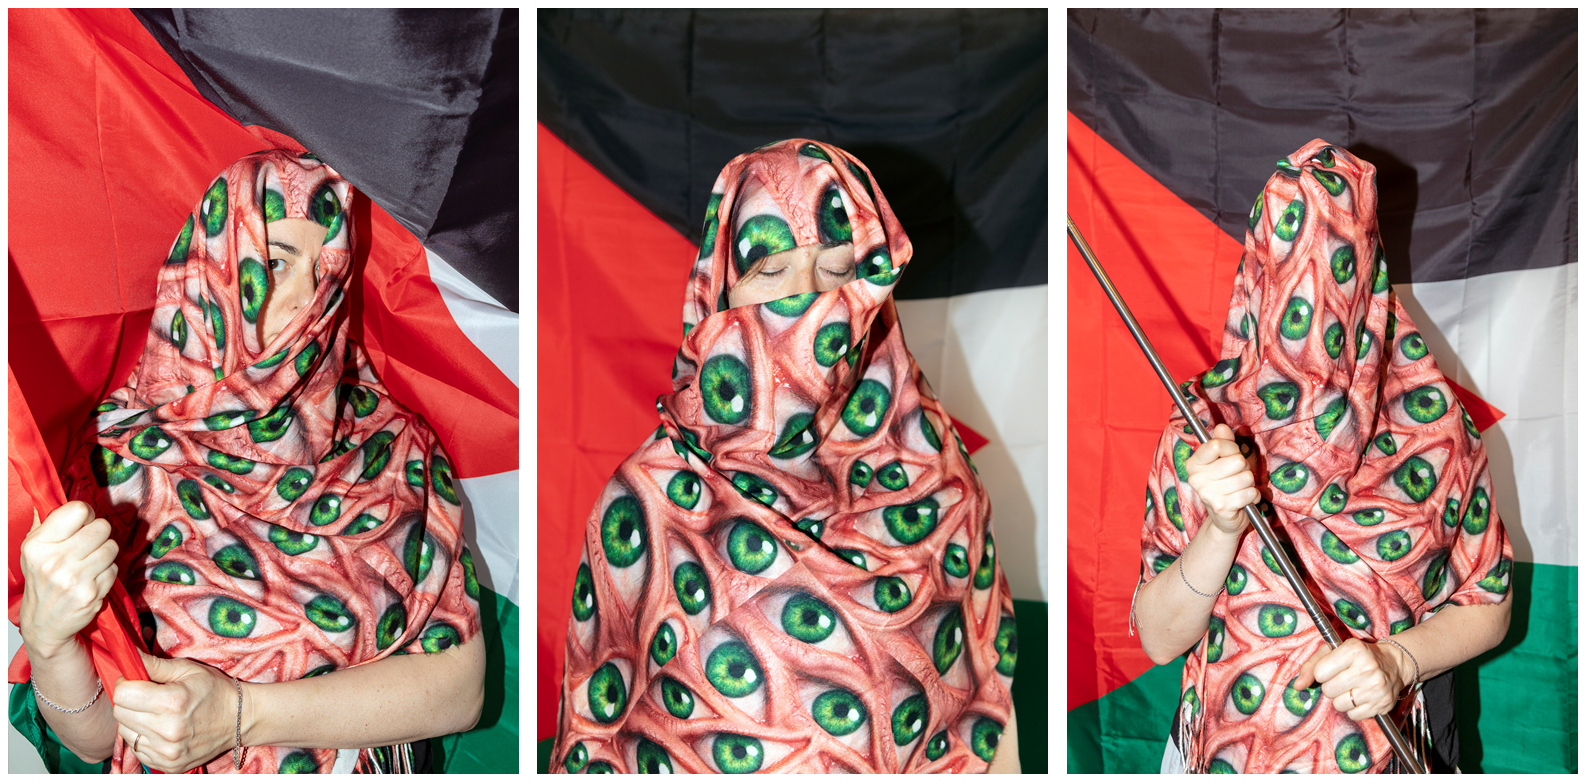
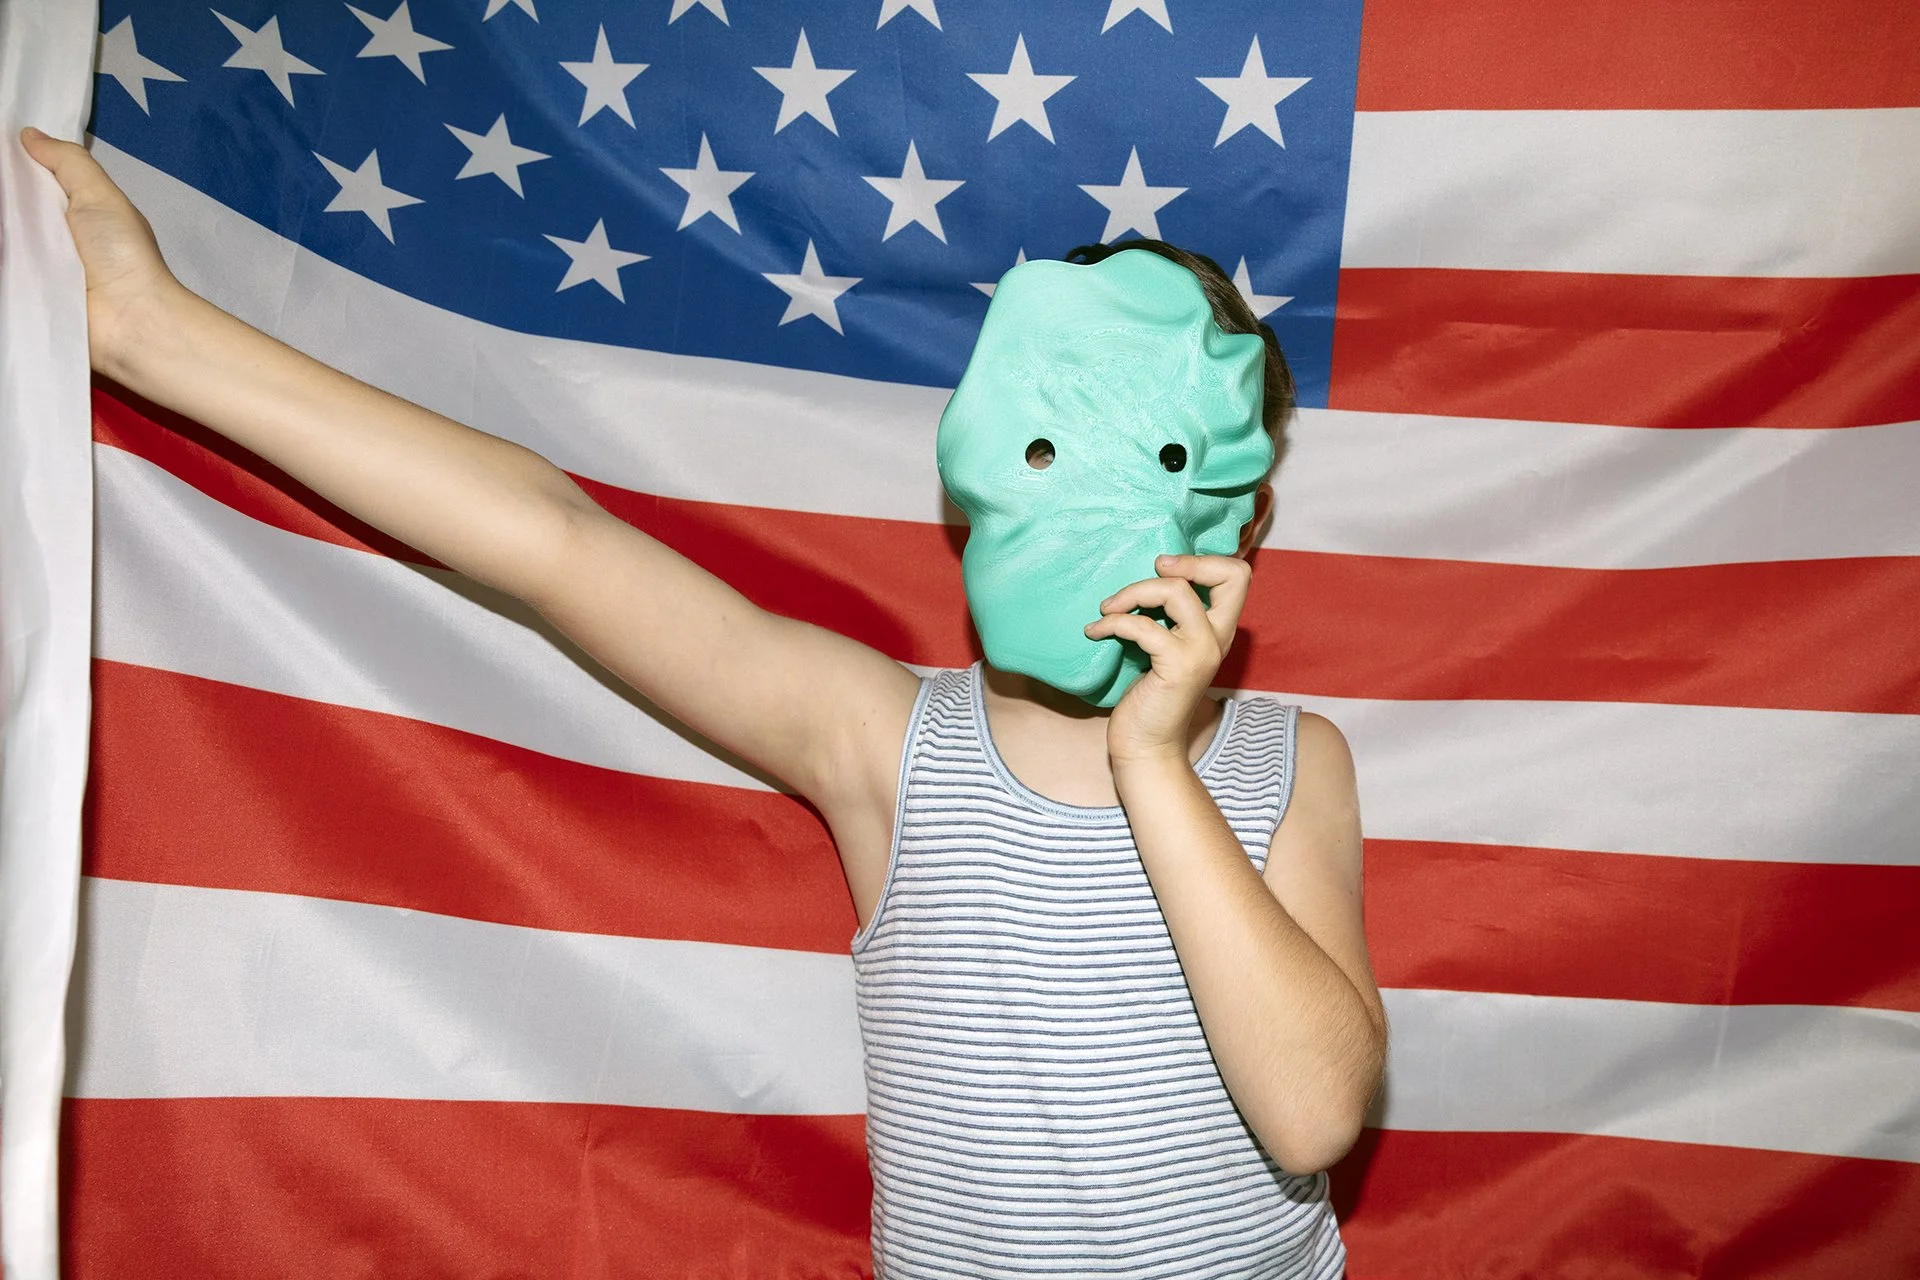
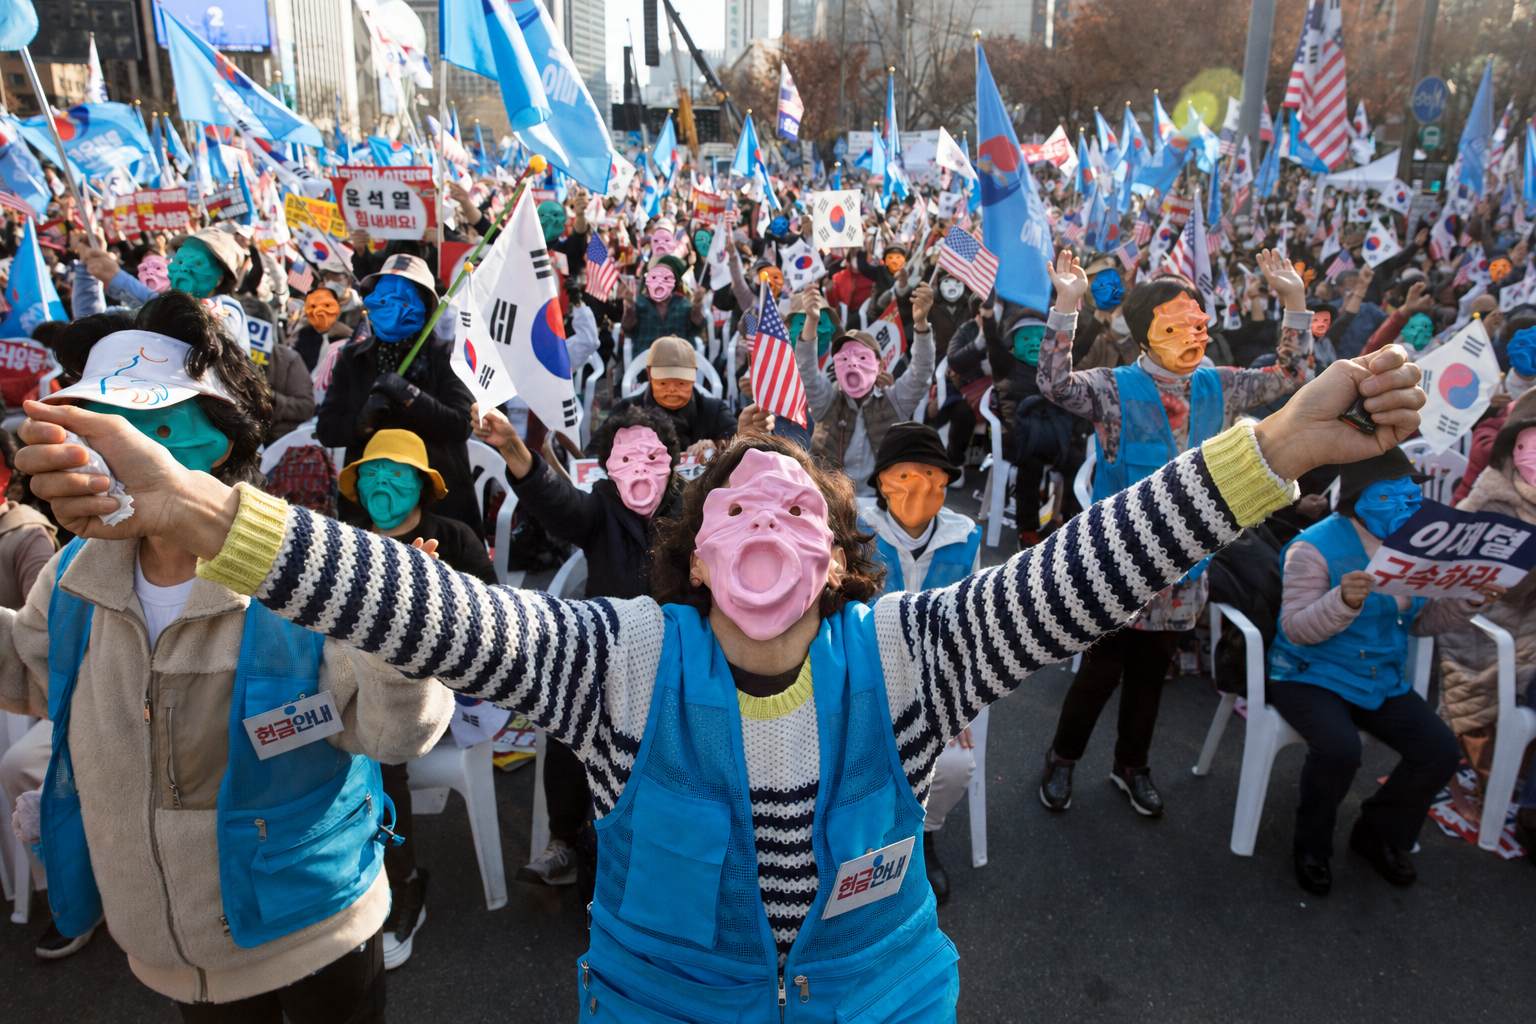
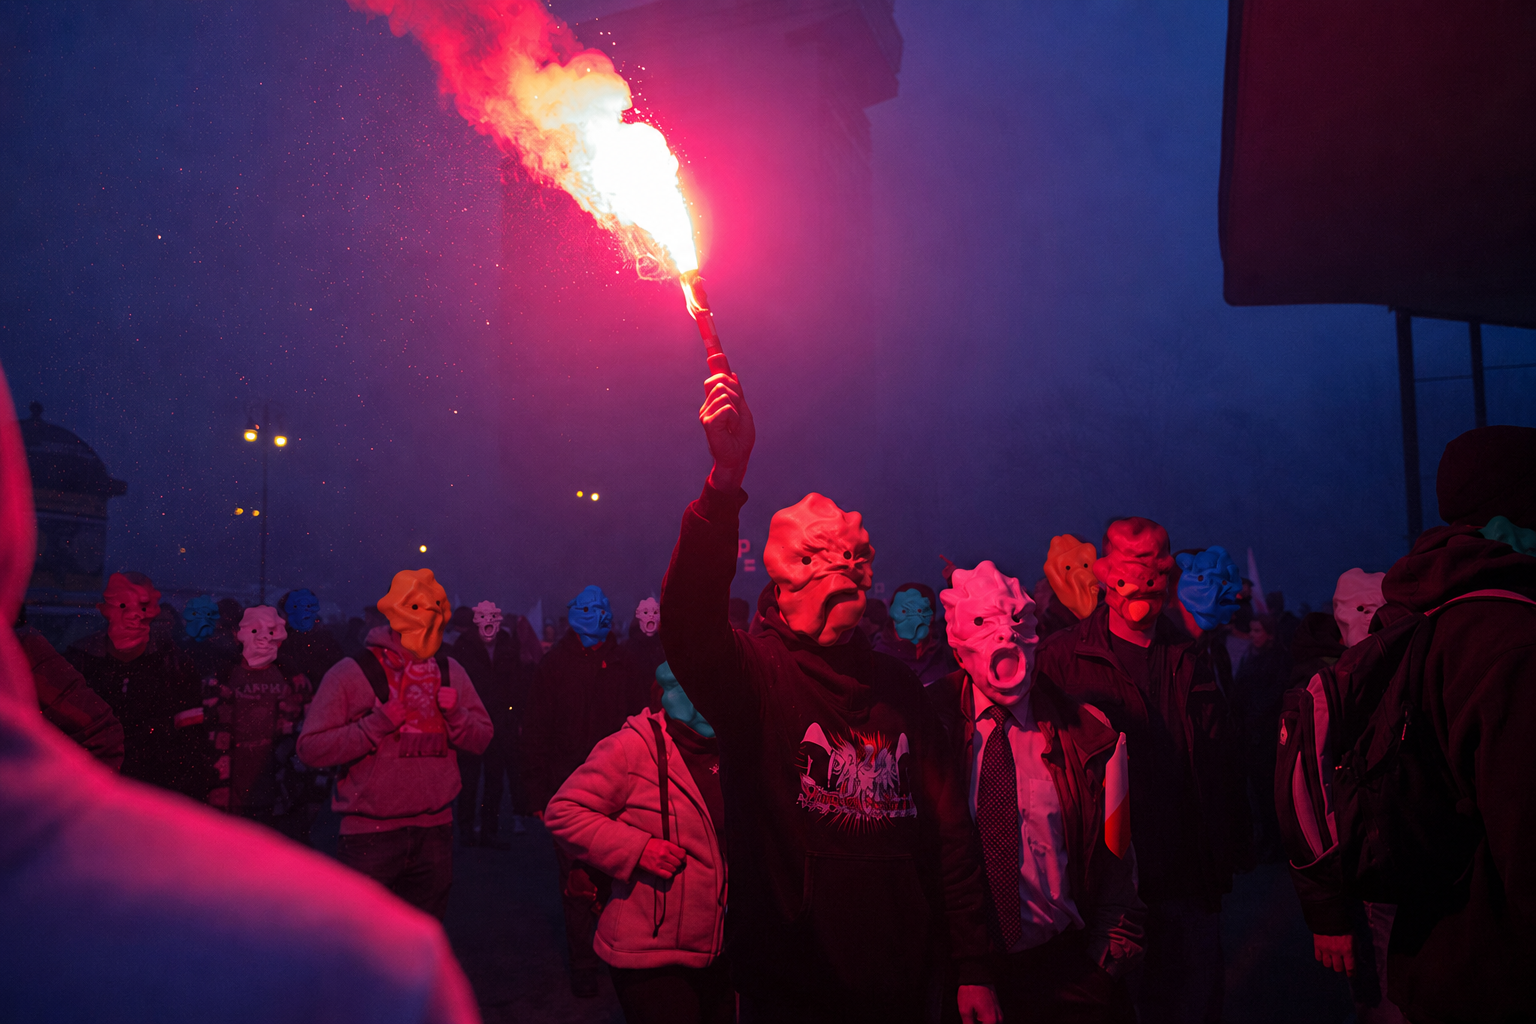
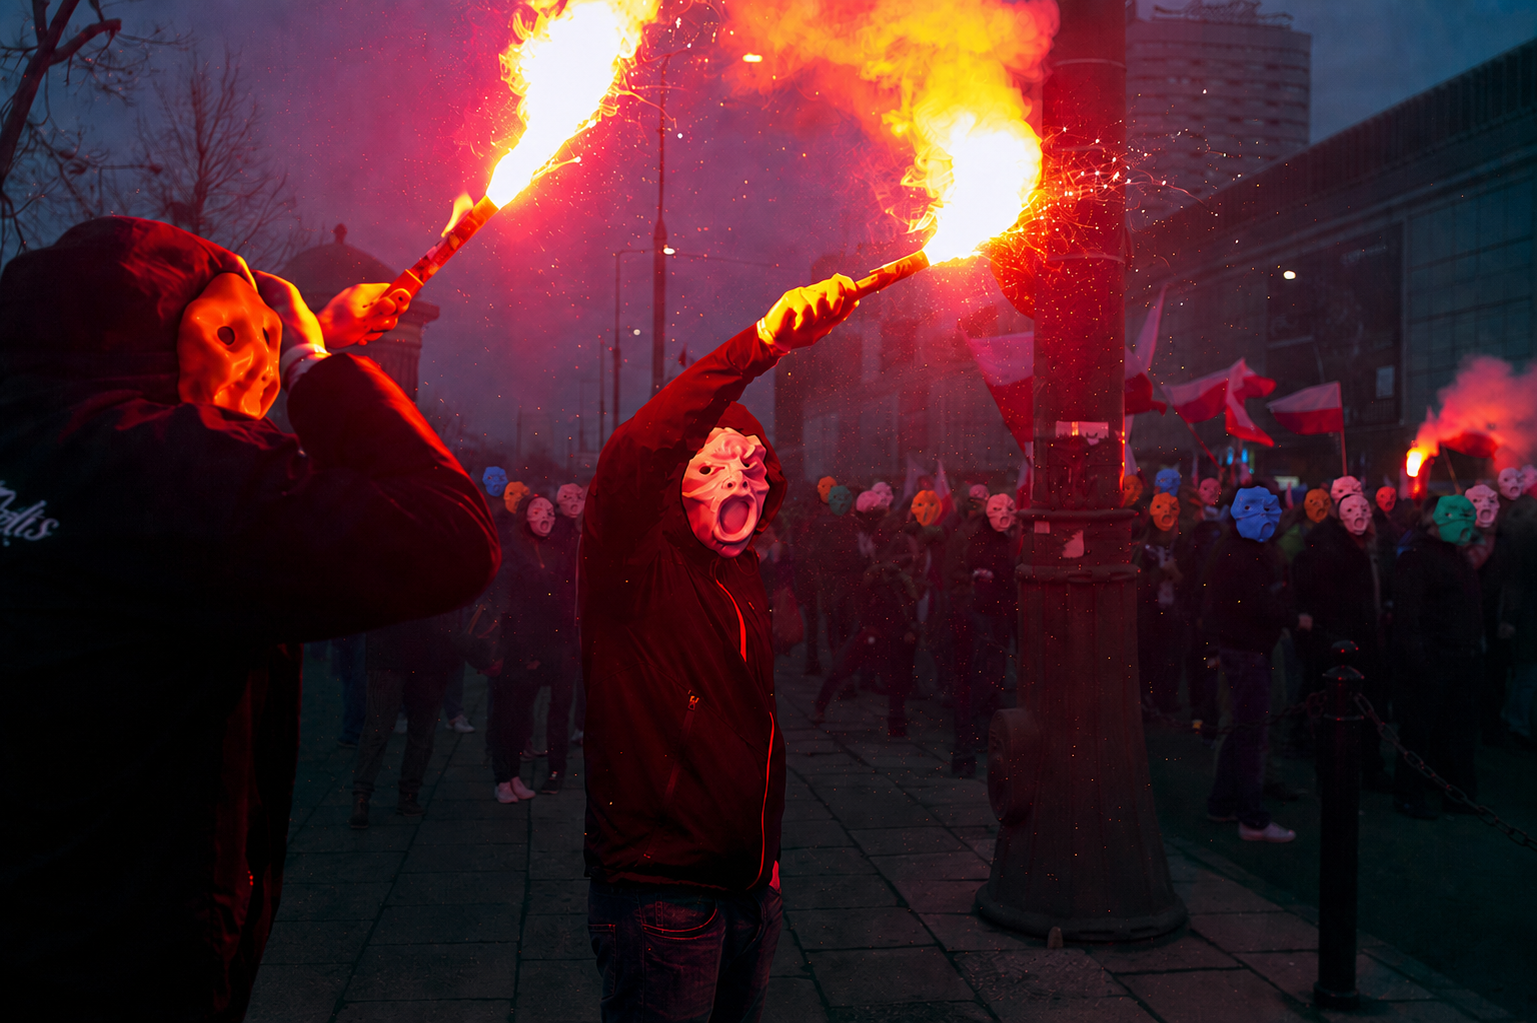
  2. Strategie di occultamento e distorsione. La forma più diretta consiste nell’occultamento del volto attraverso delle maschere. Quelle che ho ideato prendono il nome di Anòmata, sono modellate con l’IA con l’obiettivo di ingannare l’IA applicata al riconoscimento facciale e le ho realizzate attraverso la stampa 3D. Un secondo approccio consiste nell’utilizzo di capi di moda anti-biometrica da me progettati, caratterizzati da pattern ripetuti di occhi e bocche, con lo scopo di interferire con i sistemi di rilevamento e identificazione. Nei contesti in cui coprire il volto può essere vietato per legge, ho pensato al trucco facciale (di ispirazione teatrale) concepito per alterare visivamente i tratti del volto.

  3. Contro-archivio. Una serie di immagini nelle quali intervengo con l’IA sulle mie fotografie per simulare processi di identificazione automatizzata e rendere visibili logiche, errori e limiti dei sistemi di analisi biometrica.

Mi interessava quindi costruire un progetto che si muovesse continuamente tra documento, intervento e simulazione. I tre filoni non sono compartimenti separati, ma diversi livelli dello stesso discorso e altrettante posizioni dello sguardo: quello del fotografo che osserva e documenta la realtà, quello del soggetto che reagisce tentando di sottrarsi all’identificazione e quello della macchina che analizza, classifica e riconosce.

Questo lavoro rende visibile, anche in modo provocatorio, una contraddizione centrale del presente: in un mondo nel quale essere visibili significa sempre più spesso essere identificabili, l’invisibilità può diventare una forma di resistenza, ma anche una nuova condizione di esclusione dallo spazio pubblico.


Faceless Generation is a visual and documentary investigation into the relationship between identity, visibility and technological surveillance.

The project grew out of my experience as a documentary photographer in Georgia during the 2024 protests, where I observed how biometric surveillance, through facial recognition, could be deployed on a large scale to identify, track and target protesters.

This technology is now embedded in airports, borders, urban infrastructures, personal devices and security systems. It promises security, efficiency and easier access, yet at the same time introduces a form of control that is often invisible, capable of turning our presence in public space into a permanent trace. When used to monitor protests, this process directly affects freedom of expression, the right to demonstrate, and the possibility of expressing dissent without being automatically identified.

What happens when the face ceases to be simply the site of identity and becomes data to be captured and classified, made available to the very authorities that dissent seeks to challenge? Drawing on my experience in Georgia, I conceived and developed a series of concealment and distortion strategies through which the image of the face attempts to evade, confuse or produce errors in the algorithmic gaze.

The project unfolds through three types of images:

  1. Reportage. A selection of my photographs from the Georgian protests, from which the idea for this project originated, together with images from other demonstrations I have documented in different countries.

  2. Concealment and distortion strategies. The most direct approach consists in concealing the face through masks. The masks I designed, called Anòmata, were modelled using AI with the aim of deceiving AI-based facial recognition systems, and were then produced through 3D printing. A second approach involves the use of anti-biometric fashion garments of my own design, characterised by repeated patterns of eyes and mouths intended to interfere with detection and identification systems. In contexts where covering the face may be prohibited by law, I explored facial make-up, inspired by theatrical practice and conceived to visually alter facial features.

  3. Counter-archive. A series of images in which I use AI to intervene on my own photographs, simulating processes of automated identification in order to make visible the logic, errors and limitations of biometric analysis systems.

I was therefore interested in constructing a project that moves continuously between document, intervention and simulation. The three strands are not separate compartments, but different layers of the same discourse and different positions of the gaze: that of the photographer, who observes and documents reality; that of the subject, who reacts by attempting to evade identification; and that of the machine, which analyses, classifies and recognises.

This work makes visible, at times provocatively, a central contradiction of the present: in a world in which being visible increasingly means being identifiable, invisibility can become a form of resistance, but also a new condition of exclusion from public space.